

我们将首先探讨的应用是 Token 分类。这个通用任务涵盖了所有可以表述为“给句子中的词或字贴上标签”的问题,例如:
- 实体命名识别 (NER):找出句子中的实体(如人物、地点或组织)。这可以通过为每个实体指定一个类别的标签,如果没有实体则会输出无实体的标签。
- 词性标注 (POS):将句子中的每个单词标记为对应于特定的词性(如名词、动词、形容词等)。
- 分块(chunking):找出属于同一实体的 tokens 这个任务(可以与词性标注或命名实体识别结合)可以被描述为将位于块开头的 token 赋予一个标签(通常是 “
B-” (Begin),代表该token位于实体的开头),将位于块内的 tokens 赋予另一个标签(通常是 “I-”(inner)代表该token位于实体的内部),将不属于任何块的 tokens 赋予第三个标签(通常是 “O” (outer)代表该token不属于任何实体)。
当然,还有很多其他类型的 token 分类问题;这些只是几个有代表性的例子。在本节中,我们将在 NER 任务上微调模型 (BERT),然后该模型将能够生成如下预测:
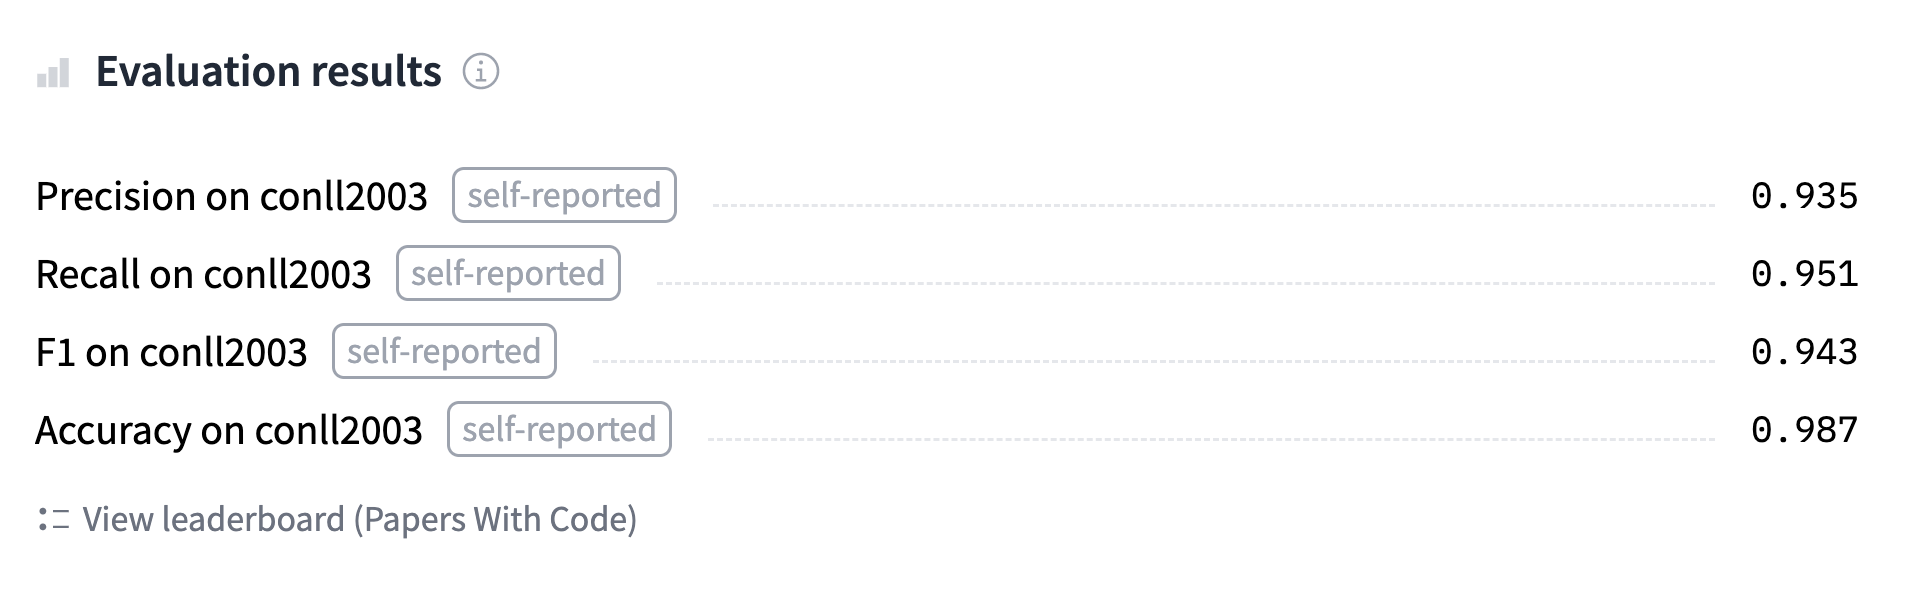
你可以 在这里 。找到我们将训练并上传到 Hub 的模型,可以尝试输入一些句子测试一下模型的预测结果。
准备数据
首先,我们需要一个适合 token 分类的数据集。在本节中,我们将使用 CoNLL-2003 数据集 ,该数据集来源于路透社的新闻报道。
💡 只要你的数据集由分词文本和对应的标签组成,就能够将这里描述的数据处理过程应用到自己的数据集中。如果需要复习如何在
Dataset中加载自定义数据集,请复习 第五章 。
CoNLL-2003 数据集
要加载 CoNLL-2003 数据集,我们可以使用🤗 Datasets 库的 load_dataset() 方法:
from datasets import load_dataset

raw_datasets = load_dataset("conll2003")
这将下载并缓存数据集,就像和我们在 第三章 加载 GLUE MRPC 数据集一样。查看 raw_datasets 对象可以让我们看到数据集中存在哪些列,以及训练集、验证集和测试集之间是如何划分的:
raw_datasets
DatasetDict({
    train: Dataset({
        features: ['chunk_tags', 'id', 'ner_tags', 'pos_tags', 'tokens'],
        num_rows: 14041
    })
    validation: Dataset({
        features: ['chunk_tags', 'id', 'ner_tags', 'pos_tags', 'tokens'],
        num_rows: 3250
    })
    test: Dataset({
        features: ['chunk_tags', 'id', 'ner_tags', 'pos_tags', 'tokens'],
        num_rows: 3453
    })
})
可以看到数据集包含了我们之前提到的三项任务的标签:命名实体识别(NER)、词性标注(POS)以及分块(chunking)。这个数据集与其他数据集的一个显著区别在于,输入文本的那一列并非以句子或整片的文本的形式存储,而是以单词列表的形式(最后一列被称为 tokens ,不过 tokens 列保存的还是单词,也就是说,这些预先分词的输入仍需要经过 tokenizer 进行子词分词处理)。
我们来看看训练集的第一个元素:
raw_datasets["train"][0]["tokens"]
['EU', 'rejects', 'German', 'call', 'to', 'boycott', 'British', 'lamb', '.']
由于我们要进行命名实体识别,让我们查看一下 NER 标签:
raw_datasets["train"][0]["ner_tags"]
[3, 0, 7, 0, 0, 0, 7, 0, 0]
这些是可以直接训练的整数类别标签,当我们想要检查数据时,直接看整数的标签不是很直观。就像在文本分类中,我们可以通过查看数据集的 features 属性来找到这些整数和标签名称之间的对应关系:
ner_feature = raw_datasets["train"].features["ner_tags"]
ner_feature
Sequence(feature=ClassLabel(num_classes=9, names=['O', 'B-PER', 'I-PER', 'B-ORG', 'I-ORG', 'B-LOC', 'I-LOC', 'B-MISC', 'I-MISC'], names_file=None, id=None), length=-1, id=None)
因此,我们得到了 ClassLabels 类型的序列。序列中元素的类型存储在 ner_feature 的 feature 中,我们可以通过查看该 feature 的 names 属性来访问标签名称的列表:
label_names = ner_feature.feature.names
label_names
['O', 'B-PER', 'I-PER', 'B-ORG', 'I-ORG', 'B-LOC', 'I-LOC', 'B-MISC', 'I-MISC']
我们在 第六章 深入研究 token-classification 管道时已经看到过这些标签 我们在这里进行一个快速的回顾:
O表示这个词不对应任何实体。B-PER/I-PER意味着这个词对应于人名实体的开头/内部。B-ORG/I-ORG的意思是这个词对应于组织名称实体的开头/内部。B-LOC/I-LOC指的是是这个词对应于地名实体的开头/内部。B-MISC/I-MISC表示这个词对应一个其他实体(不属于特定类别或类别之外)的开头 / 内部。
接下来使用对这些标签名对数据集的 ner_tags 进行解码,将得到以下输出结果:
words = raw_datasets["train"][0]["tokens"]
labels = raw_datasets["train"][0]["ner_tags"]
line1 = ""
line2 = ""
for word, label in zip(words, labels):
    full_label = label_names[label]
    max_length = max(len(word), len(full_label))
    line1 += word + " " * (max_length - len(word) + 1)
    line2 += full_label + " " * (max_length - len(full_label) + 1)

print(line1)
print(line2)
'EU    rejects German call to boycott British lamb .'
'B-ORG O       B-MISC O    O  O       B-MISC  O    O'
我们还可以查看训练集中索引为 4 的数据,它是一个同时包含 B- 和 I- 标签的例子:
'Germany \'s representative to the European Union \'s veterinary committee Werner Zwingmann said on Wednesday consumers should buy sheepmeat from countries other than Britain until the scientific advice was clearer .'
'B-LOC   O  O              O  O   B-ORG    I-ORG O  O          O         B-PER  I-PER     O    O  O         O         O      O   O         O    O         O     O    B-LOC   O     O   O          O      O   O       O'
正如我们在上面的输出中所看到的,跨越两个单词的实体,如“European Union”和“Werner Zwingmann”,数据集把第一个单词标注为了 B- 标签,将第二个单词标记为了 I- 标签。
✏️ 轮到你了! 检查同一个句子的词性标注 (POS)或分块(chunking)列,查看输出的结果。
处理数据
像往常一样,我们的文本需要转换为 Token ID,然后模型才能理解它们。正如我们在 第六章 所学的那样。不过与 tokens 分类任务不同的是数据集已经完成了预分词,我们在处理的过程中不需要再次分词。幸运的是,tokenizer API 可以很容易地处理这种差异;我们只需要通过一个特殊的标志告诉 tokenizer即可。
首先,让我们创建 tokenizer 对象。如前所述,我们将使用 BERT 预训练模型,因此我们将从下载并缓存关联的 tokenizer 开始:
from transformers import AutoTokenizer

model_checkpoint = "bert-base-cased"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
你可以更换把 model_checkpoint 更换为 Hub 上你喜欢的任何其他模型,或使用本地保存的预训练模型和 tokenizer。唯一的限制是 tokenizer 需要由 🤗 Tokenizers 库支持,并且有一个“快速”版本可用。你可以在 Huggingface 模型后端支持表 上看到所有带有快速版本的 tokenizer 架构,或者你也可以通过查看它 is_fast 属性来检测正在使用的 tokenizer 对象是否由 🤗 Tokenizers 支持:
tokenizer.is_fast
True
我们可以像往常一样使用我们的 tokenizer 对预先分词的输入进行 tokenize ,只需额外添加 is_split_into_words=True 参数:
inputs = tokenizer(raw_datasets["train"][0]["tokens"], is_split_into_words=True)
inputs.tokens()
['[CLS]', 'EU', 'rejects', 'German', 'call', 'to', 'boycott', 'British', 'la', '##mb', '.', '[SEP]']
如我们所见,tokenizer 在结果中添加了模型需要使用的特殊 tokens(在开头的 [CLS] ,在结尾的 [SEP] ),并且大部分单词保持不变。不过,单词 lamb 被分词为两个子词, la 和 ##mb 。这导致了输入和标签之间的不匹配:标签列表只有 9 个元素,而我们的输入现在有 12 个 tokens。解决特殊 tokens 的问题很容易(我们已经知道了每个 token 开始和结束的位置),我们需要确保的是我们将所有的标签与正确的词对齐。
幸运的是,由于我们使用的是快速 tokens 因此我们可以使用🤗 Tokenizers 超能力,这意味着我们可以轻松地将每个 token 映射到其相应的单词(如 第六章 中所学):
inputs.word_ids()
[None, 0, 1, 2, 3, 4, 5, 6, 7, 7, 8, None]
只需要一点点工作,我们就可以扩展我们的标签列表。我们将添加的使其与 token 列表相匹配。 添加的第一条规则是,特殊 tokens 的标签设置为 -100 。这是因为默认情况下, -100 会被我们的损失函数(交叉熵)忽略。然后将每个 token 的标签设置为这个 token 所在单词开头的 token 的标签,因为同一个单词一定是同一个实体的一部分。最后将单词的内部 tokens 标签中的 B- 替换为 I-,因为该 token 不在实体的开头,B- 在每个实体中只应该出现一次:
def align_labels_with_tokens(labels, word_ids):
    new_labels = []
    current_word = None
    for word_id in word_ids:
        if word_id != current_word:
            # 新单词的开始!
            current_word = word_id
            label = -100 if word_id is None else labels[word_id]
            new_labels.append(label)
        elif word_id is None:
            # 特殊的token
            new_labels.append(-100)
        else:
            # 与前一个 tokens 类型相同的单词
            label = labels[word_id]
            # 如果标签是 B-XXX 我们将其更改为 I-XXX
            if label % 2 == 1:
                label += 1
            new_labels.append(label)

    return new_labels
让我们在数据集的第一个元素上试一试:
labels = raw_datasets["train"][0]["ner_tags"]
word_ids = inputs.word_ids()
print(labels)
print(align_labels_with_tokens(labels, word_ids))
[3, 0, 7, 0, 0, 0, 7, 0, 0]
[-100, 3, 0, 7, 0, 0, 0, 7, 0, 0, 0, -100]
正如我们所看到的,我们的函数为开头和结尾添加了两个特殊 tokens :-100 ,并为切分成两个 tokens 的单词添加了一个新的 0 标签。
✏️ 轮到你了! 有些研究人员更喜欢只为每个单只分配一个标签,对该单词其他部分的 token 分配
-100标签。这是为了避免那些分解成许多子词的长单词对损失作出过多的贡献。请按照这个思路,改变之前的函数,使标签与 inputs ID 对齐。
为了预处理我们的整个数据集,我们需要对所有输入进行 tokenize,并使用 align_labels_with_tokens() 函数处理所有标签。为了充分利用快速 tokenizer 的优势,最好是同时对大量文本一起进行 tokenize,所以我们需要编写一个处理一组示例的函数,并使用带有 batched=True 参数的 Dataset.map() 方法。与我们之前的示例唯一不同的是,当 tokenizer 的输入是文本列表(或示例中单词的列表的列表)时, word_ids() 函数需要根据列表的索引获取 token 的 ID,所以我们也在下面的函数中添加了这个功能:
def tokenize_and_align_labels(examples):
    tokenized_inputs = tokenizer(
        examples["tokens"], truncation=True, is_split_into_words=True
    )
    all_labels = examples["ner_tags"]
    new_labels = []
    for i, labels in enumerate(all_labels):
        word_ids = tokenized_inputs.word_ids(i)
        new_labels.append(align_labels_with_tokens(labels, word_ids))

    tokenized_inputs["labels"] = new_labels
    return tokenized_inputs
注意,我们还没有填充我们的输入,我们将在稍后使用数据整理器创建 batch 时进行。
我们现在可以一次性使用预处理函数处理整个数据集:
tokenized_datasets = raw_datasets.map(
    tokenize_and_align_labels,
    batched=True,
    remove_columns=raw_datasets["train"].column_names,
)
我们已经完成了最困难的部分!现在数据已经经过了预处理,实际的训练过程将会与我们在 第三章 所做的很相似。
使用 Trainer API 微调模型
使用 Trainer 的代码会和以前一样,唯一的变化是数据如何整理成 batch 以及计算评估的分数。
整理数据
我们不能像 第三章 那样直接使用 DataCollatorWithPadding ,因为那样只会填充输入(inputs ID、注意掩码和 tokens 类型 ID)。除了输入部分,在这里我们还需要对标签也使用与输入完全相同的方式填充,以保证它与输入的大小相同。我们将使用 -100 进行填充,以便在损失计算中忽略填充的内容。
以上的这些过程可以由 DataCollatorForTokenClassification 实现。它是一个带有填充功能的数据整理器,使用时只需要传入用于预处理输入的 tokenizer :
from transformers import DataCollatorForTokenClassification

data_collator = DataCollatorForTokenClassification(tokenizer=tokenizer)
为了在几个样本上测试这个数据整理器,我们可以先在训练集中的几个示例上调用它:
batch = data_collator([tokenized_datasets["train"][i] for i in range(2)])
batch["labels"]
tensor([[-100,    3,    0,    7,    0,    0,    0,    7,    0,    0,    0, -100],
        [-100,    1,    2, -100, -100, -100, -100, -100, -100, -100, -100, -100]])
将数据整理器的结果与数据集中未经处理的第一个和第二个元素的标签进行比较。
for i in range(2):
    print(tokenized_datasets["train"][i]["labels"])
[-100, 3, 0, 7, 0, 0, 0, 7, 0, 0, 0, -100]
[-100, 1, 2, -100]
正如我们所看到的,已经使用 -100 将第二组标签填充到了与第一组标签相同的长度。
评估指标
要让 Trainer 在每个周期计算一个指标,我们需要定义一个 compute_metrics() 函数,该函数的输入是预测值和标签的数组,并返回带有指标名称和评估结果的字典。
用于评估 Token 分类预测的经典框架是 seqeval 。要使用此指标,我们首先需要安装 seqeval 库:
!pip install seqeval
然后我们可以通过 evaluate.load() 函数加载它,就像我们在 第三章 中所做的那样:
import evaluate

metric = evaluate.load("seqeval")
该指标和常规的评测指标有些区别:它需要字符串形式的标签列表而不是整数,所以我们需要在将它们传递给指标之前将预测值和标签由数字解码为字符串。让我们先用一些测试数据看看它是如何工作的:
首先,获取第一个训练样本的标签。
labels = raw_datasets["train"][0]["ner_tags"]
labels = [label_names[i] for i in labels]
labels
['B-ORG', 'O', 'B-MISC', 'O', 'O', 'O', 'B-MISC', 'O', 'O']
然后我们可以通过更改索引 2 处的值来为这些标签创建假的预测值来测试该指标:
predictions = labels.copy()
predictions[2] = "O"
metric.compute(predictions=[predictions], references=[labels])
请注意,该指标的输入是预测列表(不是一个)和标签列表,输出结果如下:
{'MISC': {'precision': 1.0, 'recall': 0.5, 'f1': 0.67, 'number': 2},
 'ORG': {'precision': 1.0, 'recall': 1.0, 'f1': 1.0, 'number': 1},
 'overall_precision': 1.0,
 'overall_recall': 0.67,
 'overall_f1': 0.8,
 'overall_accuracy': 0.89}
结果返回很多信息!包括每个单独实体及整体的准确率、召回率和 F1 分数。在这里我们将只保留总分,但是你可以自由地调整 compute_metrics() 函数返回的所需要指标。这个函数中我们首先会先取预测 logits 的 argmax,并将其转换为预测值。 compute_metrics() 函数首先取 logits 的 argmax,将它们转换为预测值(通常情况下,logits 和概率的顺序是相同,所以我们不需要使用 softmax)。然后我们需要将标签和预测值都从整数转换为字符串。我们删除所有标签为 -100 的值,最后将结果传递给 metric.compute() 方法:
import numpy as np


def compute_metrics(eval_preds):
    logits, labels = eval_preds
    predictions = np.argmax(logits, axis=-1)

    # 删除忽略的索引(特殊 tokens )并转换为标签
    true_labels = [[label_names[l] for l in label if l != -100] for label in labels]
    true_predictions = [
        [label_names[p] for (p, l) in zip(prediction, label) if l != -100]
        for prediction, label in zip(predictions, labels)
    ]
    all_metrics = metric.compute(predictions=true_predictions, references=true_labels)
    return {
        "precision": all_metrics["overall_precision"],
        "recall": all_metrics["overall_recall"],
        "f1": all_metrics["overall_f1"],
        "accuracy": all_metrics["overall_accuracy"],
    }
现在已经完成了,我们下面就可以开始定义我们的 Trainer 了。接下来我们只需要一个 model 并对其微调!
定义模型
由于我们正在研究 Token 分类问题,因此我们将使用 AutoModelForTokenClassification 类。定义此模型时要记得传递我们标签的数量,最简单方法是将该数字传递给 num_labels 参数,但是如果我们想要一个就像我们在本节开头看到的那样的推理小部件,就需要用最标准的方法正确设置标签的对应关系。
最标准的方式是用两个字典 id2label 和 label2id 来设置标签,这两个字典包含从 ID 到标签的映射以及反向的映射:
id2label = {str(i): label for i, label in enumerate(label_names)}
label2id = {v: k for k, v in id2label.items()}
现在我们只需将它们传递给 AutoModelForTokenClassification.from_pretrained() 方法,它们就会被保存在模型的配置中,然后被正确地保存和上传到 Hub:
from transformers import AutoModelForTokenClassification

model = AutoModelForTokenClassification.from_pretrained(
    model_checkpoint,
    id2label=id2label,
    label2id=label2id,
)
就像我们在 第三章 中定义 AutoModelForSequenceClassification 类一样 创建模型会发出一个警告,提示一些权重未被使用(来自预训练头部的权重)和一些其他权重被随机初始化(来自新 Token 分类头部的权重),不过不用担心,我们马上就要训练这些权重。在这之前,让我们先确认一下我们的模型是否具有正确的标签数量:
model.config.num_labels
9
⚠️ 如果你的模型的标签数量有错误,那么在后面调用
Trainer.train()时,你会得到一个晦涩的错误(类似于“CUDA error:device-side assert triggered”)。这可能会令人烦恼,所以确保你做了这个检查,确认你的标签数量是正确。
微调模型
我们现在准备好训练我们的模型了!在定义 Trainer 之前,我们只需要做最后两件事:登录 Hugging Face 并设置我们的训练参数。如果你在 notebook 上工作,有一个方便的小工具可以帮助你:
from huggingface_hub import notebook_login

notebook_login()
登录后,我们就可以设置我们的 TrainingArguments :
from transformers import TrainingArguments

args = TrainingArguments(
    "bert-finetuned-ner",
    evaluation_strategy="epoch",
    save_strategy="epoch",
    learning_rate=2e-5,
    num_train_epochs=3,
    weight_decay=0.01,
    push_to_hub=True,
)
你已经对大多数内容有所了解了:我们设置了一些超参数(如学习率、训练的轮数和权重衰减),并设定 push_to_hub=True ,表示我们希望在每个训练轮次结束时保存并评估模型,然后将结果上传到模型中心。注意,你可以通过 hub_model_id 参数指定你想推送的仓库的名称(特别需要注意的是,如果你需要推送给某个组织,就必须使用这个参数)。例如,当我们将模型推送到 huggingface-course 组织 时,我们在 TrainingArguments 中添加了 hub_model_id="huggingface-course/bert-finetuned-ner" 。默认情况下,使用的仓库将保存在你的账户之内,并以你设置的输出目录命名,所以在我们的例子中,仓库的地址是 "sgugger/bert-finetuned-ner" 。
💡 如果你使用的输出路径已经存在一个同名的文件夹,那么它需要是你想推送到 hub 的仓库的克隆在本地的版本。如果不是,你将在声明
Trainer时遇到一个错误,并需要设置一个新的路径。
最后,我们将所有内容传递给 Trainer 并启动训练:
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    compute_metrics=compute_metrics,
    tokenizer=tokenizer,
)
trainer.train()
请注意,在训练过程中每次保存模型时(这里是每个 epooch),它都会在后台上传到 Hub。这样,如有必要,你将能够在另一台机器上继续你的训练。
训练完成后,我们使用 push_to_hub() 上传模型的最新版本
trainer.push_to_hub(commit_message="Training complete")
如果你想检查一下是否上传成功,这个命令会返回刚刚执行的提交的 URL:
'https://huggingface.co/sgugger/bert-finetuned-ner/commit/26ab21e5b1568f9afeccdaed2d8715f571d786ed'
同时 Trainer 还创建并上传了一张包含所有评估结果的模型卡。到此阶段,你可以在模型 Hub 上使用推理小部件来测试你的模型并与你的朋友分享。你已经成功地在一个 tokens 分类任务上微调了一个模型——恭喜你!
如果你想更深入地了解训练循环,我们现在将向你展示如何使用 🤗 Accelerate 做同样的事情。
自定义训练循环
现在我们来看看完整的训练循环,这样你就可以轻松地定制你需要的部分。它与我们在 第三章 中所做的内容很相似,但对评估部分有一些改动。
做好训练前的准备
首先我们需要为我们的数据集构建 DataLoader 。我们将 data_collator 传递给 collate_fn 参数并随机打乱训练集,但不打乱验证集:
from torch.utils.data import DataLoader

train_dataloader = DataLoader(
    tokenized_datasets["train"],
    shuffle=True,
    collate_fn=data_collator,
    batch_size=8,
)
eval_dataloader = DataLoader(
    tokenized_datasets["validation"], collate_fn=data_collator, batch_size=8
)
接下来我们重新实例化我们的模型,以确保我们不是继续之前的微调,而是重新开始从 BERT 微调预训练模型:
model = AutoModelForTokenClassification.from_pretrained(
    model_checkpoint,
    id2label=id2label,
    label2id=label2id,
)
然后我们需要一个优化器。我们将使用经典 AdamW ,它类似于 Adam ,但在权重衰减的方式上进行了改进:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=2e-5)
当我们拥有了所有这些对象之后,我们就可以将它们发传递给 accelerator.prepare() 方法:
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
🚨 如果你正在 TPU 上训练,你需要将上面单元格开始的所有代码移动到一个专门的训练函数中。更多详情请回顾 第三章 。
现在我们已经将我们的 train_dataloader 传递给了 accelerator.prepare() 方法,我们还可以使用 len() 来计算训练步骤的数量。请记住,我们应该在准备好 dataloader 后再使用 len() ,因为改动 dataloader 会改变训练长度的数量。这里我们将使用一个从学习率衰减到 0 的经典线性学习率调度:
from transformers import get_scheduler

num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
最后,为了将我们的模型推送到 Hub,我们需要在一个工作文件夹中创建一个 Repository 对象。如果你还没有登录的话,首先需要登录到 Hugging Face,然后根据模型 ID 来确定仓库名称(你可以将 repo_name 替换为你喜欢的名字;只需要包含你的用户名即可,你可以使用 get_full_repo_name() 函数的查看目前的 repo_name ):
from huggingface_hub import Repository, get_full_repo_name

model_name = "bert-finetuned-ner-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/bert-finetuned-ner-accelerate'
然后我们可以将该仓库克隆到本地文件夹中。如果本地已经存在同名的文件夹,这个本地文件夹必须是我们正在使用的仓库克隆在本地的版本:
output_dir = "bert-finetuned-ner-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
我们现在可以通过调用 repo.push_to_hub() 方法上传保存在 output_dir 中的所有内容。它帮助我们在每个训练周期结束时上传中间模型。
训练循环
我们现在准备编写完整的训练循环。为了简化其评估部分,我们定义了一个 postprocess() 函数,该函数会接收模型的预测和真实的标签,并将它们转换为字符串列表,也就是我们的 metric (评估函数)对象需要的输入格式。
def postprocess(predictions, labels):
    predictions = predictions.detach().cpu().clone().numpy()
    labels = labels.detach().cpu().clone().numpy()

    # 删除忽略的索引(特殊 tokens )并转换为标签
    true_labels = [[label_names[l] for l in label if l != -100] for label in labels]
    true_predictions = [
        [label_names[p] for (p, l) in zip(prediction, label) if l != -100]
        for prediction, label in zip(predictions, labels)
    ]
    return true_labels, true_predictions
然后我们可以编写训练循环。在定义一个进度条来跟踪训练的进度后,循环分为三个部分:
- 训练本身,这是经典的迭代过程,即在
train_dataloader上进行迭代,在模型上前向传播训练数据,然后反向传递loss和优化参数 - 评估,在获取模型在一个
batch上的输出之后,这里有一个需要注意的地方:由于两个进程可能已将输入和标签填充到不同的形状,我们需要使用accelerator.pad_across_processes()使预测和真实的标签在调用gather()方法之前具有相同的形状。如果我们不这样做,评估循环将会出错或无限期卡住。最后我们将结果发送到metric.add_batch()方法中,并在评估循环结束时调用metric.compute()方法。 - 保存和上传,首先保存模型和
tokenizer然后调用repo.push_to_hub()方法。注意,我们使用参数blocking=False来告诉 🤗Hub库在一个异步进程中推送。这样,在训练时,这个指令在后台将模型和tokenizer推送到hub。
以下是完整的训练循环代码:
from tqdm.auto import tqdm
import torch

progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # 训练
    model.train()
    for batch in train_dataloader:
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # 评估
    model.eval()
    for batch in eval_dataloader:
        with torch.no_grad():
            outputs = model(**batch)

        predictions = outputs.logits.argmax(dim=-1)
        labels = batch["labels"]

        # 填充模型的预测和标签后才能调用 gathere()
        predictions = accelerator.pad_across_processes(predictions, dim=1, pad_index=-100)
        labels = accelerator.pad_across_processes(labels, dim=1, pad_index=-100)

        predictions_gathered = accelerator.gather(predictions)
        labels_gathered = accelerator.gather(labels)

        true_predictions, true_labels = postprocess(predictions_gathered, labels_gathered)
        metric.add_batch(predictions=true_predictions, references=true_labels)

    results = metric.compute()
    print(
        f"epoch {epoch}:",
        {
            key: results[f"overall_{key}"]
            for key in ["precision", "recall", "f1", "accuracy"]
        },
    )

    # 保存并上传
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
如果这是你第一次看到使用 🤗 Accelerate 保存模型,让我们花点时间来了解一下这个过程中的三行代码:
accelerator.wait_for_everyone()
unwrapped_model = accelerator.unwrap_model(model)
unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
第一行是不言自明的:它告诉所有的进程先等待,直到所有的进程都处于这个阶段再继续(阻塞)。这是为了确保在保存之前,我们在每个进程中都有相同的模型。 第二行代码用于获取 unwrapped_model ,它就是我们定义的基本模型。 accelerator.prepare() 方法会为了在分布式训练中工作而对模型进行了一些修改,所以它不再有 save_pretraining() 方法;使用 accelerator.unwrap_model() 方法可以撤销对模型的更改。 在第三行代码中,我们调用 save_pretraining() ,并指定 accelerator.save() 作为 save_function 而不是默认的 torch.save() 。
完成这些操作后,你应该拥有一个与 Trainer 训练出的模型结果相当类似的模型。你可以在 huggingface-course/bert-finetuned-ner-accelerate 查看我们使用这些代码训练的模型。如果你想在训练循环中测试任何调整,你可以直接通过编辑上面显示的代码来实现它们!
使用微调模型
我们已经向你展示了如何使用在模型中心微调的模型和推理小部件。在本地使用 pipeline 来使用它非常容易,你只需要指定正确的模型标签:
from transformers import pipeline

# 将此替换为你自己的 checkpoint
model_checkpoint = "huggingface-course/bert-finetuned-ner"
token_classifier = pipeline(
    "token-classification", model=model_checkpoint, aggregation_strategy="simple"
)
token_classifier("My name is Sylvain and I work at Hugging Face in Brooklyn.")
[{'entity_group': 'PER', 'score': 0.9988506, 'word': 'Sylvain', 'start': 11, 'end': 18},
 {'entity_group': 'ORG', 'score': 0.9647625, 'word': 'Hugging Face', 'start': 33, 'end': 45},
 {'entity_group': 'LOC', 'score': 0.9986118, 'word': 'Brooklyn', 'start': 49, 'end': 57}]
太棒了!我们的模型与此管道的默认模型一样有效!
微调掩码语言模型(masked language model)
对于许多涉及 Transformer 模型的 NLP 任务,你可以简单地从 Hugging Face Hub 中获取一个预训练的模型,然后直接在你的数据上对其进行微调,以完成手头的任务。只要用于预训练的语料库与用于微调的语料库没有太大区别,迁移学习通常会产生很好的结果。
但是,在某些情况下,你可能需要先在你的数据上微调语言模型,然后再训练特定于任务的 head。例如,如果你的数据集包含法律合同或科学文章,像 BERT 这样的普通 Transformer 模型通常会将你语料库中的特定领域词视为稀有 tokens ,导致性能可能不尽如人意。通过在特定领域内数据上微调语言模型,你可以提高许多下游任务的性能,这意味着你通常只需执行一次此步骤!
这种在特定领域内数据上微调预训练语言模型的过程通常称为 领域适应(domain adaptation) 。它于 2018 年由 ULMFiT 推广, NLP 的首批神经架构之一 (基于 LSTM)。下图显示了使用 ULMFiT这是使迁移学习真正适用于 进行领域自适应的示例;在本节中,我们将做类似的事情,但我们将使用 Transformer 而不是 LSTM!

在本节结束时,你将在 Hub 上拥有一个 掩码语言模型(masked language model) ,该模型可以自动补全句子,如下所示:
让我们开始吧!
🙋 如果你对“掩码语言建模”和“预训练模型”这两个术语感到陌生,请回顾 第一章 ,我们在其中解释了所有这些核心概念,并附有视频!
选择用于掩码语言建模的预训练模型
首先,让我们为掩码语言建模选择一个合适的预训练模型。如以下屏幕截图所示,你可以通过在 Hugging Face Hub 上选择“Fill-Mask”过滤器:
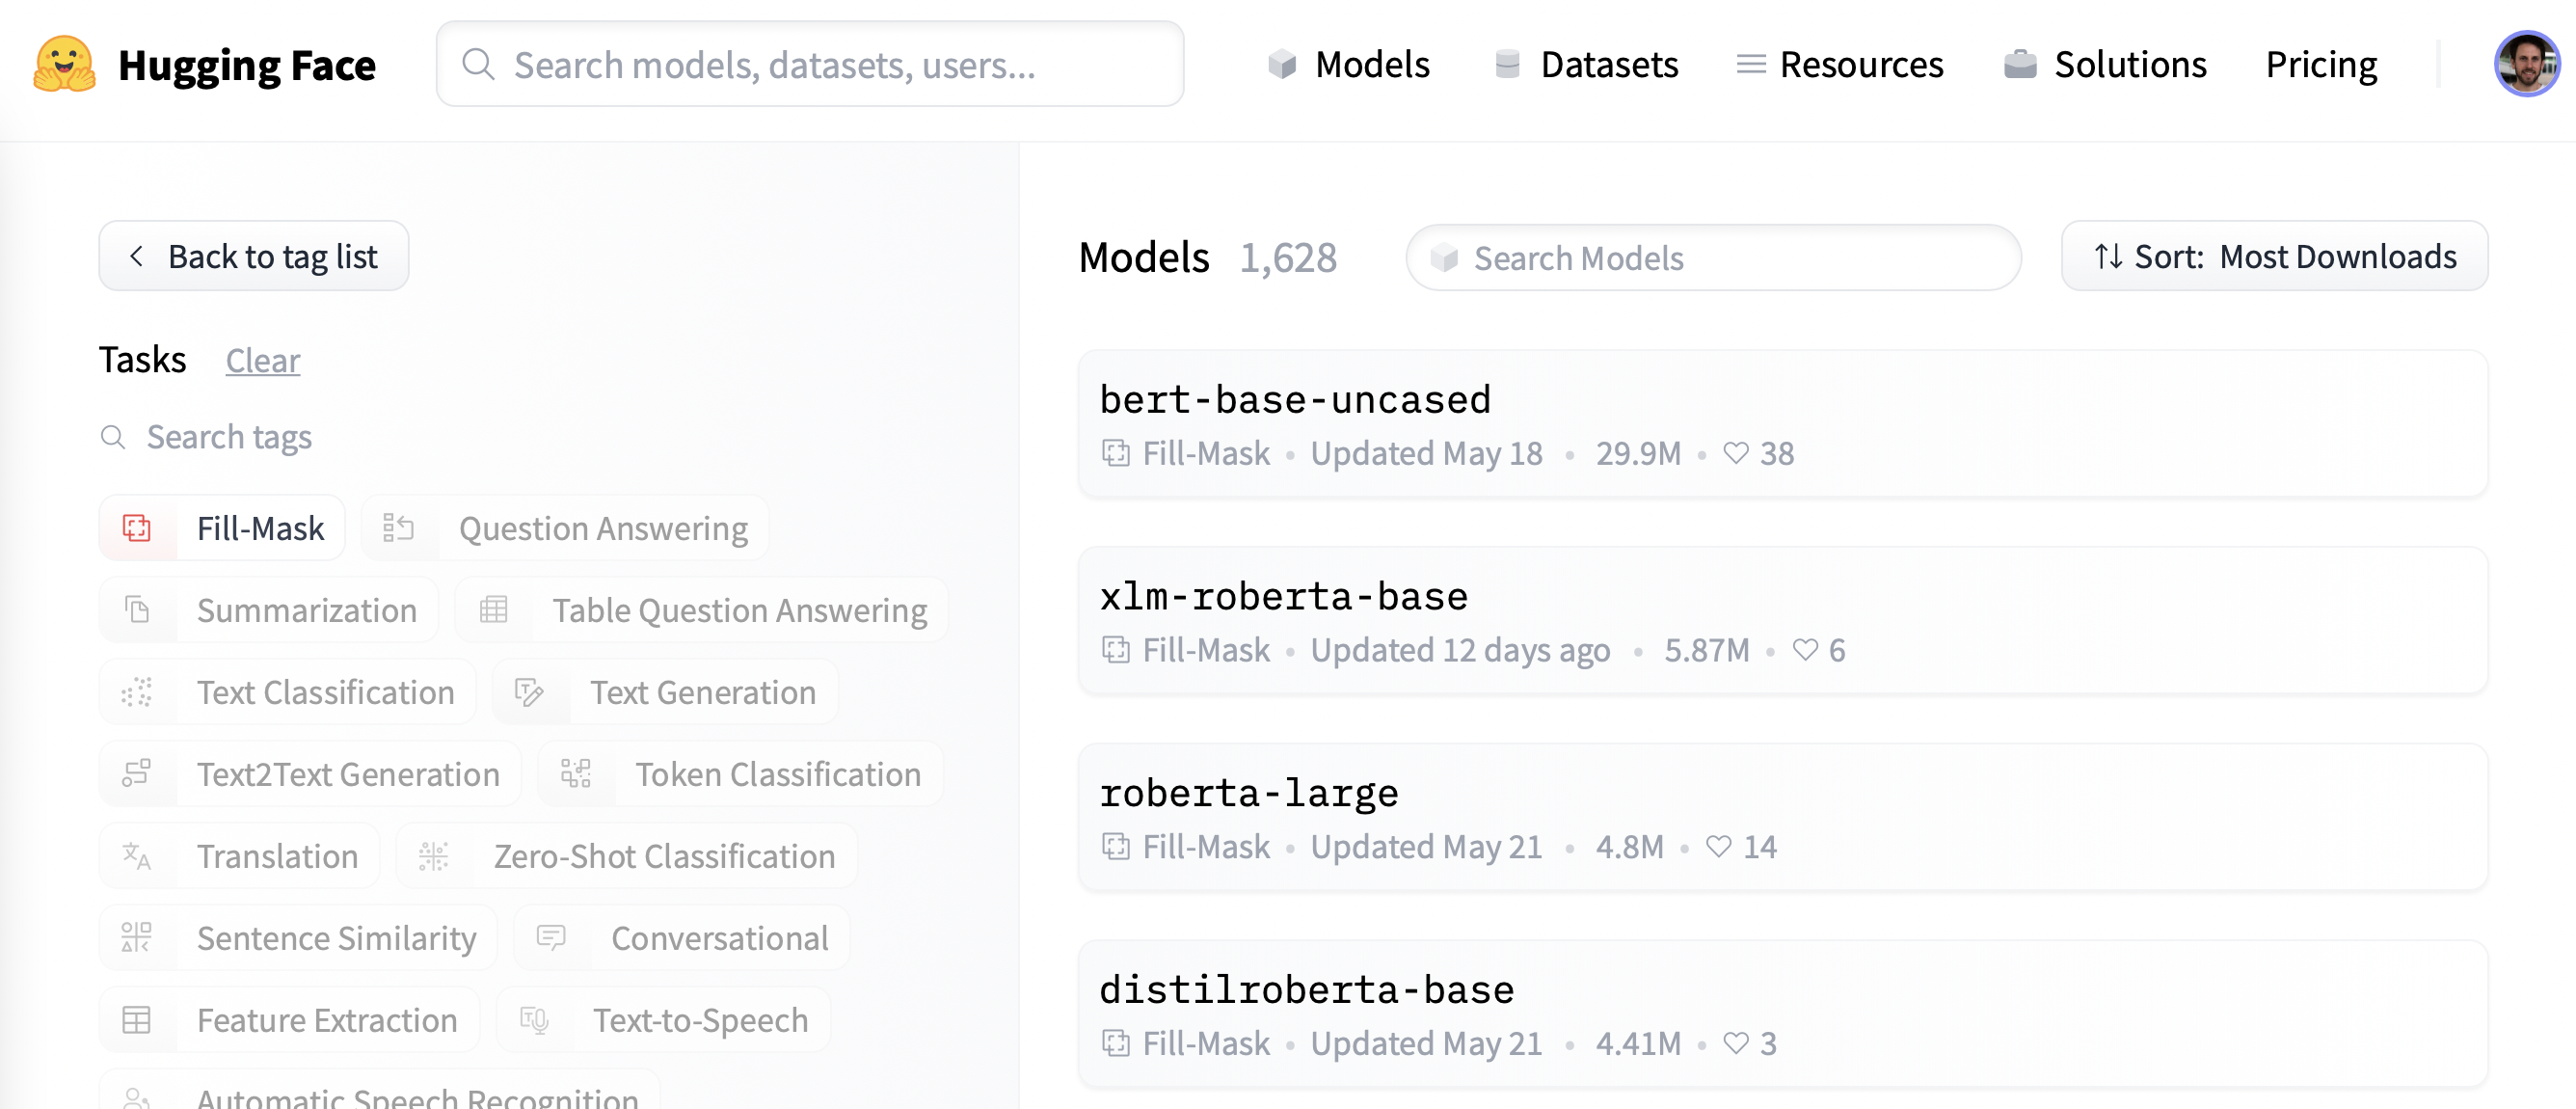
尽管 BERT 和 RoBERTa 系列模型的下载量最大,但我们将使用名为 DistilBERT 的模型。它可以更快地训练,而且对下游性能几乎没有损失。它使用了一种称为 知识蒸馏(knowledge distillation) 的特殊技术进行训练,其中使用像 BERT 这样的大型“教师模型”来指导参数少得多的“学生模型”的训练。在本节中对知识蒸馏进行详细解释会使我们偏离本节主题太远,但如果你有兴趣,可以阅读 使用 Transformers 进行自然语言处理(Natural Language Processing with Transformers) (俗称 Transformers 教科书)中知识蒸馏的相关内容。
让我们继续,我们可以使用 AutoModelForMaskedLM 类下载 DistilBERT:
from transformers import AutoModelForMaskedLM

model_checkpoint = "distilbert-base-uncased"
model = AutoModelForMaskedLM.from_pretrained(model_checkpoint)
然后,我们可以通过调用 num_parameters() 方法查看模型有多少参数:
distilbert_num_parameters = model.num_parameters() / 1_000_000
print(f"'>>> DistilBERT number of parameters: {round(distilbert_num_parameters)}M'")
print(f"'>>> BERT number of parameters: 110M'")
'>>> DistilBERT number of parameters: 67M'
'>>> BERT number of parameters: 110M'
DistilBERT 大约有 6700 万个参数,大约只有 BERT base 模型的二分之一,这大致意味着训练的速度可以提高两倍 —— 非常棒!现在让我们看看对于下面的一小部分文本,这个模型最有可能预测什么:
text = "This is a great [MASK]."
作为人类,我们可以想象 [MASK] token 有很多可能性,例如 “day”、“ride” 或者 “painting”。对于预训练模型,预测取决于模型所训练的语料库,因为它会学习获取数据中存在的语料统计分布。与 BERT 一样,DistilBERT 在 English Wikipedia 和 BookCorpus 数据集上进行预训练,所以我们猜想模型对 [MASK] 的预测能够反映这些领域。为了预测 [MASK] ,我们需要 DistilBERT 的 tokenizer 来处理输入,所以让我们也从 Hub 下载它:
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
有了 tokenizer 和模型,我们现在可以将我们的示例文本传递给模型,提取 logits,并打印出前 5 个候选词:
import torch

inputs = tokenizer(text, return_tensors="pt")
token_logits = model(**inputs).logits
# 找到 [MASK] 的位置并提取其 logits
mask_token_index = torch.where(inputs["input_ids"] == tokenizer.mask_token_id)[1]
mask_token_logits = token_logits[0, mask_token_index, :]
# 选择具有最高 logits 的 [MASK] 候选词
top_5_tokens = torch.topk(mask_token_logits, 5, dim=1).indices[0].tolist()

for token in top_5_tokens:
    print(f"'>>> {text.replace(tokenizer.mask_token, tokenizer.decode([token]))}'")
'>>> This is a great deal.'
'>>> This is a great success.'
'>>> This is a great adventure.'
'>>> This is a great idea.'
'>>> This is a great feat.'
我们可以从输出中看到,模型的预测的是日常术语,考虑到模型训练的语料数据主要来源于维基百科,这并不奇怪。现在让我们看看如何将这个领域改变成稍微更加独特——高度两极分化的电影评论!
数据集
为了展示领域适应性,我们将使用来自IMDB的 大型电影评论数据集(Large Movie Review Dataset),这是一个电影评论语料库,通常用于对情感分析模型进行基准测试。通过在这个语料库上对 DistilBERT 进行微调,我们期望语言模型会从其预训练的维基百科的事实性数据,适应到更主观的电影评论的领域。
首先,我们可以使用🤗 Datasets 中的 load_dataset() 函数从 Hugging Face 中获取数据:
from datasets import load_dataset

imdb_dataset = load_dataset("imdb")
imdb_dataset
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 25000
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 25000
    })
    unsupervised: Dataset({
        features: ['text', 'label'],
        num_rows: 50000
    })
})
我们可以看到 train 和 test 分别包含了 25,000 条评论,还有一个没有的标签的 unsupervised(无监督) 部分包含 50,000 条评论。接下来让我们从里面取一些样本,来了解一下我们正在处理的文本的特点。正如我们在本课程的前几章中所做的那样,我们将把 Dataset.shuffle() 函数链接到 Dataset.select() 函数创建随机样本:
sample = imdb_dataset["train"].shuffle(seed=42).select(range(3))

for row in sample:
    print(f"\n'>>> Review: {row['text']}'")
    print(f"'>>> Label: {row['label']}'")
'>>> Review: This is your typical Priyadarshan movie--a bunch of loony characters out on some silly mission. His signature climax has the entire cast of the film coming together and fighting each other in some crazy moshpit over hidden money. Whether it is a winning lottery ticket in Malamaal Weekly, black money in Hera Pheri, "kodokoo" in Phir Hera Pheri, etc., etc., the director is becoming ridiculously predictable. Don\'t get me wrong; as clichéd and preposterous his movies may be, I usually end up enjoying the comedy. However, in most his previous movies there has actually been some good humor, (Hungama and Hera Pheri being noteworthy ones). Now, the hilarity of his films is fading as he is using the same formula over and over again.<br /><br />Songs are good. Tanushree Datta looks awesome. Rajpal Yadav is irritating, and Tusshar is not a whole lot better. Kunal Khemu is OK, and Sharman Joshi is the best.'
'>>> Label: 0'

'>>> Review: Okay, the story makes no sense, the characters lack any dimensionally, the best dialogue is ad-libs about the low quality of movie, the cinematography is dismal, and only editing saves a bit of the muddle, but Sam" Peckinpah directed the film. Somehow, his direction is not enough. For those who appreciate Peckinpah and his great work, this movie is a disappointment. Even a great cast cannot redeem the time the viewer wastes with this minimal effort.<br /><br />The proper response to the movie is the contempt that the director San Peckinpah, James Caan, Robert Duvall, Burt Young, Bo Hopkins, Arthur Hill, and even Gig Young bring to their work. Watch the great Peckinpah films. Skip this mess.'
'>>> Label: 0'

'>>> Review: I saw this movie at the theaters when I was about 6 or 7 years old. I loved it then, and have recently come to own a VHS version. <br /><br />My 4 and 6 year old children love this movie and have been asking again and again to watch it. <br /><br />I have enjoyed watching it again too. Though I have to admit it is not as good on a little TV.<br /><br />I do not have older children so I do not know what they would think of it. <br /><br />The songs are very cute. My daughter keeps singing them over and over.<br /><br />Hope this helps.'
'>>> Label: 1'
是的,这些肯定是电影评论,如果你年龄足够大,你甚至可能会理解上述评论中关于拥有 VHS (一种古老的盒式摄像机格式)版本的评论😜!虽然语言模型不需要预先标注好的标签,但我们已经可以看到数据集其实包含了标签, 0 代表负面评论, 1 代表正面评论。
✏️ 试一试! 创建一个
unsupervised部分的随机样本,并验证其标签既不是0也不是1。或者,你也可以检查train和test部分的标签确实是0或1—— 每个 NLP 实践者在开始新项目时都应该对数据标注进行的有用的、合理的检查!
现在我们已经快速浏览了一下数据,接下来我们要深入准备这些数据以供进行掩码语言建模。如我们所见,与我们在 第三章 看到的序列分类任务相比,这里需要采取一些额外的步骤。让我们开始吧!
预处理数据
对于自回归和掩码语言建模,常见的预处理步骤是将所有的文本拼接起来,然后再将整个语料库切割为相同大小的块。这与我们之前的做法有很大的不同,我们之前只是对单个的示例进行 tokenize。为什么要将所有的示例连接在一起呢?原因是如果单个示例太长,可能会被截断,这会导致我们失去可能对语言建模任务有用的信息!
因此,我们首先会像往常一样对语料库进行 tokenize 处理,但是不在 tokenizer 中设置 truncation=True 选项。如果我们有可以使用快速 tokenizer(如 第六章 中所述),除此之外,我们还需要获取单词的 ID,因为后面我们需要用到它们来进行全词掩码。最后我们将把这个过程封装在一个简单的函数中,并删除 text 和 label 列,因为我们不再需要它们。
def tokenize_function(examples):
    result = tokenizer(examples["text"])
    if tokenizer.is_fast:
        result["word_ids"] = [result.word_ids(i) for i in range(len(result["input_ids"]))]
    return result


# 使用 batched=True 来激活快速多线程!
tokenized_datasets = imdb_dataset.map(
    tokenize_function, batched=True, remove_columns=["text", "label"]
)
tokenized_datasets
DatasetDict({
    train: Dataset({
        features: ['attention_mask', 'input_ids', 'word_ids'],
        num_rows: 25000
    })
    test: Dataset({
        features: ['attention_mask', 'input_ids', 'word_ids'],
        num_rows: 25000
    })
    unsupervised: Dataset({
        features: ['attention_mask', 'input_ids', 'word_ids'],
        num_rows: 50000
    })
})
由于 DistilBERT 是一个类似 BERT 的模型,我们可以看到编码后的文本包含了我们在之前章节中看到的 input_ids 和 attention_mask ,以及我们添加的 word_ids 。
现在我们已经对电影评论进行了 tokenize,下一步是将它们全部组合在一起并将结果分割成块。但是,这些块应该有多大呢?这最终将取决于你可以使用的显存大小,但一个好的起点是查看模型的最大上下文大小。这可以在 tokenizer 的 model_max_length 属性中找到:
tokenizer.model_max_length
512
该值来自于与 checkpoint 相关联的 tokenizer_config.json 文件;在我们的例子中,我们可以看到上下文大小是 512 个 tokens 与 BERT 模型一样。
✏️ 试试看! 一些 Transformer 模型,例如 BigBird 和 Longformer 具有比 BERT 和其他早期 Transformer 模型更长的上下文长度。选择一个
checkpoint来实例化tokenizer并验证model_max_length是否与模型卡上标注的大小一致。
因此,为了可以在像 Google Colab 那样的 GPU 上运行我们的实验,我们会选择一个稍小一点、可以放入内存中的分块大小:
chunk_size = 128
注意,在实际应用场景中,使用小的块可能会有丢失长句子之间的语义信息从而对最终模型的性能产生不利的影响,所以如果显存条件允许的话,你应该选择一个与你将要使用模型的相匹配的大小。
现在来到了最有趣的部分。为了展示如何把这些示例连接在一,我们从分词后的训练集中取出几个评论,并打印出每个评论的 token 数量:
# 切片会为每个特征生成一个列表的列表
tokenized_samples = tokenized_datasets["train"][:3]

for idx, sample in enumerate(tokenized_samples["input_ids"]):
    print(f"'>>> Review {idx} length: {len(sample)}'")
'>>> Review 0 length: 200'
'>>> Review 1 length: 559'
'>>> Review 2 length: 192'
然后,我们可以用一个简单的字典推导式将所有这些示例连接在一起,如下所示:
concatenated_examples = {
    k: sum(tokenized_samples[k], []) for k in tokenized_samples.keys()
}
total_length = len(concatenated_examples["input_ids"])
print(f"'>>> Concatenated reviews length: {total_length}'")
'>>> Concatenated reviews length: 951'
很棒,总长度计算出来了 —— 现在,让我们将连接的评论拆分为大小为 chunk_size 的块。为此,我们迭代了 concatenated_examples 中的特征,并使用列表推导式为每个特征分块。结果是一个字典,键是特征的名称,值是对应值经过分块的列表:
chunks = {
    k: [t[i : i + chunk_size] for i in range(0, total_length, chunk_size)]
    for k, t in concatenated_examples.items()
}

for chunk in chunks["input_ids"]:
    print(f"'>>> Chunk length: {len(chunk)}'")
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 55'
正如你在这个例子中看到的,最后一个块通常会小于所设置的分块的大小。有两种常见的策略来处理这个问题:
- 如果最后一个块小于
chunk_size,就丢弃。 - 填充最后一个块,直到其长度等于
chunk_size。
我们将在这里采用第一种方法,最后让我们将上述所有逻辑包装在一个函数中,以便我们可以将其应用于我们的已分词数据集上:
def group_texts(examples):
    # 拼接所有的文本
    concatenated_examples = {k: sum(examples[k], []) for k in examples.keys()}
    # 计算拼接文本的长度
    total_length = len(concatenated_examples[list(examples.keys())[0]])
    # 如果最后一个块小于 chunk_size,我们将其丢弃
    total_length = (total_length // chunk_size) * chunk_size
    # 按最大长度分块
    result = {
        k: [t[i : i + chunk_size] for i in range(0, total_length, chunk_size)]
        for k, t in concatenated_examples.items()
    }
    # 创建一个新的 labels 列
    result["labels"] = result["input_ids"].copy()
    return result
注意,在 group_texts() 的最后一步,我们创建了一个新的 labels 列,它是通过复制 input_ids 列形成的。这是因为在掩码语言模型的目标是预测输入中随机遮住(Masked)的 token,我们保存了让我们的语言模型从中学习 [Mask] 的答案。
现在,让我们使用我们强大的 Dataset.map() 函数将 group_texts() 应用到我们的已分词数据集上:
lm_datasets = tokenized_datasets.map(group_texts, batched=True)
lm_datasets
DatasetDict({
    train: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 61289
    })
    test: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 59905
    })
    unsupervised: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 122963
    })
})
通过对文本进行分块,我们得到了比原来的训练集和测试集的 25000 个例子多得多的评论数据。这是因为我们现在有了涉及跨越原始语料库中多个例子的连续标记的例子。你可以通过在其中一个块中查找特殊的 [SEP] 和 [CLS] tokens 来清晰地看到这一点:
tokenizer.decode(lm_datasets["train"][1]["input_ids"])
".... at.......... high. a classic line : inspector : i'm here to sack one of your teachers. student : welcome to bromwell high. i expect that many adults of my age think that bromwell high is far fetched. what a pity that it isn't! [SEP] [CLS] homelessness ( or houselessness as george carlin stated ) has been an issue for years but never a plan to help those on the street that were once considered human who did everything from going to school, work, or vote for the matter. most people think of the homeless"
在这个例子中,你可以看到两个重叠的电影评论,一个关于高中电影,另一个关于无家可归的问题。让我们也检查一下掩码语言模型待预测的标签是什么样的:
tokenizer.decode(lm_datasets["train"][1]["labels"])
".... at.......... high. a classic line : inspector : i'm here to sack one of your teachers. student : welcome to bromwell high. i expect that many adults of my age think that bromwell high is far fetched. what a pity that it isn't! [SEP] [CLS] homelessness ( or houselessness as george carlin stated ) has been an issue for years but never a plan to help those on the street that were once considered human who did everything from going to school, work, or vote for the matter. most people think of the homeless"
正如我们上面的 group_texts() 函数所预期的那样,这看起来与解码的 input_ids 完全相同 —— 但是要怎么样才能让我们的的模型可以学习到一些东西呢?我们缺少一个关键的步骤:在输入中随机插入 [MASK] token!让我们看看如何在微调期间使用特殊的数据整理器来实时地完成这个步骤。
使用 Trainer API 微调 DistilBERT
微调掩码语言模型几乎与微调序列分类模型相同,就像我们在 第三章 所做的那样。唯一的区别是我们需要一个特殊的数据整理器,它可以随机屏蔽每批文本中的一些 tokens。幸运的是,🤗 Transformers 为这项任务准备了专用的 DataCollatorForLanguageModeling 。我们只需要将 tokenizer 和一个 mlm_probability 参数(掩盖 tokens 的比例)传递给它。在这里我们将 mlm_probability 参数设置为 15%,这是 BERT 默认的数量,也是文献中最常见的选择。
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm_probability=0.15)
为了了解随机掩码数据整理器的工作原理,让我们把一些例子输入到数据整理器。由于数据整理器期望接收一个字典列表,其中每个字典中存储一段连续文本的块,所以我们首先遍历数据集取出来一些样本数据,然后将样本数据输入到整理器。在输入到数据整理器之间,我们删除了 word_ids 这个键,因为它不需要这个键。
samples = [lm_datasets["train"][i] for i in range(2)]
for sample in samples:
    _ = sample.pop("word_ids")

for chunk in data_collator(samples)["input_ids"]:
    print(f"\n'>>> {tokenizer.decode(chunk)}'")
'>>> [CLS] bromwell [MASK] is a cartoon comedy. it ran at the same [MASK] as some other [MASK] about school life, [MASK] as " teachers ". [MASK] [MASK] [MASK] in the teaching [MASK] lead [MASK] to believe that bromwell high\'[MASK] satire is much closer to reality than is " teachers ". the scramble [MASK] [MASK] financially, the [MASK]ful students whogn [MASK] right through [MASK] pathetic teachers\'pomp, the pettiness of the whole situation, distinction remind me of the schools i knew and their students. when i saw [MASK] episode in [MASK] a student repeatedly tried to burn down the school, [MASK] immediately recalled. [MASK]...'

'>>> .... at.. [MASK]... [MASK]... high. a classic line plucked inspector : i\'[MASK] here to [MASK] one of your [MASK]. student : welcome to bromwell [MASK]. i expect that many adults of my age think that [MASK]mwell [MASK] is [MASK] fetched. what a pity that it isn\'t! [SEP] [CLS] [MASK]ness ( or [MASK]lessness as george 宇in stated )公 been an issue for years but never [MASK] plan to help those on the street that were once considered human [MASK] did everything from going to school, [MASK], [MASK] vote for the matter. most people think [MASK] the homeless'
很棒,成功了!我们可以看到, [MASK] tokens 已随机插入我们文本中的不同位置。这些将是我们的模型在训练期间必须预测的 tokens —— 数据整理器的美妙之处在于,它会在每个 batch 中随机插入 [MASK] !
✏️ 试一试! 多运行上面的代码片段几次,亲眼看看随机遮蔽的效果!也可以用
tokenizer.convert_ids_to_tokens()替换tokenizer.decode()方法,看看只把一个给定单词的单个 token 遮蔽,而保持这个单词其他 tokens 不变的效果。
随机掩码的一个缺点是,当使用 Trainer 时,每次计算出来的评估结果会有些许不同,即使我们会对训练集和测试集使用相同的数据整理器。稍后,我们在学习使用 🤗 Accelerate 进行微调时, 就会看到如何利用灵活的自定义评估循环的来冻结随机性。
在为掩码语言建模训练模型时,不仅仅可以遮蔽单个 token,还可以一次遮蔽整个单词的所有 token,这种方法被称为全词屏蔽(whole word masking)。如果我们想使用全词屏蔽(whole word masking),我们就需要自己构建一个数据整理器。数据整理器的核心是一个函数,它接受一个样本列表并将它们转换为一个 batch,所以现在让我们这样做吧!我们将使用先前计算的word ID,构建一个单词索引和相应 token 之间的映射,然后随机决定遮蔽哪些单词,并使用这种方法对输入进行遮蔽。请注意,除了与掩码对应的标签外,所有其他的标签均应该设置为 -100 。
import collections
import numpy as np

from transformers import default_data_collator

wwm_probability = 0.2


def whole_word_masking_data_collator(features):
    for feature in features:
        word_ids = feature.pop("word_ids")

        # 创建一个单词与对应 token 索引之间的映射
        mapping = collections.defaultdict(list)
        current_word_index = -1
        current_word = None
        for idx, word_id in enumerate(word_ids):
            if word_id is not None:
                if word_id != current_word:
                    current_word = word_id
                    current_word_index += 1
                mapping[current_word_index].append(idx)

        # 随机遮蔽单词
        mask = np.random.binomial(1, wwm_probability, (len(mapping),))
        input_ids = feature["input_ids"]
        labels = feature["labels"]
        new_labels = [-100] * len(labels)
        for word_id in np.where(mask)[0]:
            word_id = word_id.item()
            for idx in mapping[word_id]:
                new_labels[idx] = labels[idx]
                input_ids[idx] = tokenizer.mask_token_id
        feature["labels"] = new_labels

    return default_data_collator(features)
接下来,我们可以在之前的样本上试试它:
samples = [lm_datasets["train"][i] for i in range(2)]
batch = whole_word_masking_data_collator(samples)

for chunk in batch["input_ids"]:
    print(f"\n'>>> {tokenizer.decode(chunk)}'")
'>>> [CLS] bromwell high is a cartoon comedy [MASK] it ran at the same time as some other programs about school life, such as " teachers ". my 35 years in the teaching profession lead me to believe that bromwell high\'s satire is much closer to reality than is " teachers ". the scramble to survive financially, the insightful students who can see right through their pathetic teachers\'pomp, the pettiness of the whole situation, all remind me of the schools i knew and their students. when i saw the episode in which a student repeatedly tried to burn down the school, i immediately recalled.....'

'>>> .... [MASK] [MASK] [MASK] [MASK]....... high. a classic line : inspector : i\'m here to sack one of your teachers. student : welcome to bromwell high. i expect that many adults of my age think that bromwell high is far fetched. what a pity that it isn\'t! [SEP] [CLS] homelessness ( or houselessness as george carlin stated ) has been an issue for years but never a plan to help those on the street that were once considered human who did everything from going to school, work, or vote for the matter. most people think of the homeless'
✏️ 试试看! 多次运行上面的代码片段,亲眼看看随机遮蔽的效果!也可以将
tokenizer.decode()方法替换为tokenizer.convert_ids_to_tokens(),可以观察到给定单词的所有 tokens 总是被一起遮蔽。
现在我们有了两个数据整理器,剩下的微调步骤与其他任务类似都是标准的。如果你在 Google Colab 上运行并且没有幸运地分配到神秘的 P100 GPU😭,那么训练可能会需要一些时间,所以我们首先将训练集的大小减小到几千个例子。不用担心,我们仍然可以得到一个相当不错的语言模型!在 🤗 Datasets 中快速筛选数据集的方法是使用我们在 第五章 中看到的 Dataset.train_test_split() 函数:
train_size = 10_000
test_size = int(0.1 * train_size)

downsampled_dataset = lm_datasets["train"].train_test_split(
    train_size=train_size, test_size=test_size, seed=42
)
downsampled_dataset
DatasetDict({
    train: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 10000
    })
    test: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 1000
    })
})
运行上述代码会自动创建新的 train 和 test 数据集,训练集大小为 10,000 个示例,验证的大小是训练集的 10% —— 如果你有一个强大的 GPU,可以自行增加这个比例!我们接下来要做的事情是登录 Hugging Face Hub。如果你在 Notebook 中运行这段代码,你可以通过以下的工具函数进行登录:
from huggingface_hub import notebook_login

notebook_login()
它将显示一个小部件,在其中你可以输入你的账号和密码进行登陆。或者,你也可以在你最喜欢的终端中输入指令:
huggingface-cli login
然后在那里登录。
登陆后,我们可以指定 Trainer 的参数:
from transformers import TrainingArguments

batch_size = 64
# 在每个 epoch 输出训练的 loss
logging_steps = len(downsampled_dataset["train"]) // batch_size
model_name = model_checkpoint.split("/")[-1]

training_args = TrainingArguments(
    output_dir=f"{model_name}-finetuned-imdb",
    overwrite_output_dir=True,
    evaluation_strategy="epoch",
    learning_rate=2e-5,
    weight_decay=0.01,
    per_device_train_batch_size=batch_size,
    per_device_eval_batch_size=batch_size,
    push_to_hub=True,
    fp16=True,
    logging_steps=logging_steps,
)
在这里,我们调整了一些默认选项,包括 logging_steps ,以确保我们可以跟踪每个 epoch 的训练损失。我们还使用了 fp16=True 来实现混合精度训练,从而进一步提高训练速度。默认情况下, Trainer 将删除模型的 forward() 方法中未使用的列。这意味着,如果你使用全词屏蔽(whole word masking)数据整理器,你还需要设置 remove_unused_columns=False ,以确保我们不会在训练期间丢失 word_ids 列。
请注意,你可以使用 hub_model_id 参数指定你想推送到的仓库的名称(如果你想把它推送到一个组织,就必须使用这个参数)。例如,当我们将模型推送到 huggingface-course 组织 时,就在 TrainingArguments 中添加了 hub_model_id="huggingface-course/distilbert-finetuned-imdb" 。默认情况下,使用的仓库将保存在你的账户中并以你设置的输出目录命名,因此在我们的示例中,它将是 "lewtun/distilbert-finetuned-imdb" 。
现在,我们拥有了初始化 Trainer 所需的所有要素。这里我们只使用了标准的 data_collator ,但你可以尝试使用全词屏蔽作为数据整理器的一个练习,并对比一下不同屏蔽方式的结果有什么不同:
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=downsampled_dataset["train"],
    eval_dataset=downsampled_dataset["test"],
    data_collator=data_collator,
    tokenizer=tokenizer,
)
我们现在准备运行 trainer.train() —— 但在此之前让我们简要地看一下 困惑度(perplexity) ,这是评估语言模型性能常用的指标。
语言模型的困惑度(perplexity)
语言建模与文本分类或问答等其他任务有所不同,在其他任务中,我们会得到一个带标签的语料库进行训练,而语言建模则没有任何明确的标签。那么我们如何确定什么是好的语言模型呢?就像手机中的自动更正功能一样,一个好的语言模型会较高概率输出一个语法正确的句子,较低概率输出无意义的句子。为了给你一个更直观感受,你可以在网上找到一整套“自动更正失败”的例子。其中,人们手机中的模型产生了一些相当有趣(并且常常不妥当)的自动生成的结果!
如果测试集主要由语法正确的句子组成,那么衡量语言模型质量的一种方式就是计算它给测试集中所有句子的下一个词的概率。高概率表示模型对未见过的例子不感到“惊讶”或“困惑”,这表明它已经学习了语言的基本语法模式。困惑度有很多种数学定义,我们将使用的定义是交叉熵损失的指数。具体方法是使用 Trainer.evaluate()方法计算测试集上的交叉熵损失,取结果的指数来计算预训练模型的困惑度。
import math

eval_results = trainer.evaluate()
print(f">>> Perplexity: {math.exp(eval_results['eval_loss']):.2f}")
Perplexity: 21.75
较低的困惑度分数意味着更好的语言模型,我们可以看到,我们的初始模型的困惑度相当地高。让我们看看我们是否可以通过微调来降低它!为此,我们首先运行训练循环:
trainer.train()
然后像之前那样计算测试集上的结果困惑度:
eval_results = trainer.evaluate()
print(f">>> Perplexity: {math.exp(eval_results['eval_loss']):.2f}")
Perplexity: 11.32
太棒了——困惑度显著降低,这告诉我们模型已经学习到了电影评论领域的一些知识!
一旦训练完成,我们可以将带有训练信息的模型卡片推送到 Hub(checkpoint 在训练过程中就已经保存了):
trainer.push_to_hub()
✏️ 轮到你了! 将数据整理器改为全词屏蔽的数据整理器后运行上面的训练。你能得到更好的结果吗?
在我们的使用案例中,我们不需要对训练循环做任何特殊的处理,但在某些情况下,你可能需要实现一些自定义逻辑。对于这些应用,你可以使用 🤗 Accelerate —— 让我们看一看!
使用 🤗 Accelerate 微调 DistilBERT
从上面的 Trainer 训练流程中我们就能发现,微调一个掩码的语言模型与 第三章 中的文本分类非常相似。事实上,唯一的不同之处是使用了一个特殊的数据整理器,我们已经在本节的前面讨论过这个问题了! 然而,我们注意到 DataCollatorForLanguageModeling 在每次评估时也会进行随机遮罩,因此我们在每次训练运行中都会看到困惑度得分有些波动。消除这种随机性的一种方法是在整个测试集上 仅进行一次 遮罩,然后在评估过程中使用🤗 Transformers 中的默认数据整理器来收集 batch。为实现这个过程,让我们实现一个简单的函数,类似于我们第一次使用 DataCollatorForLanguageModeling 时进行遮罩的方式:
def insert_random_mask(batch):
    features = [dict(zip(batch, t)) for t in zip(*batch.values())]
    masked_inputs = data_collator(features)
    # 为数据集中的每一列创建一个新的"masked"列
    return {"masked_" + k: v.numpy() for k, v in masked_inputs.items()}
接下来,我们将上述函数应用到测试集,并删除未进行遮罩的列,这样就实现了使用遮罩过的数据替换原始输入的数据。你可以通过将上述 data_collator 替换为支持全词遮罩的数据整理器并且删除下面的第一行(全词遮罩的数据整理器需要 word_ids 列来定位同一个单词中的不同 token)来实现全词遮罩
downsampled_dataset = downsampled_dataset.remove_columns(["word_ids"])
eval_dataset = downsampled_dataset["test"].map(
    insert_random_mask,
    batched=True,
    remove_columns=downsampled_dataset["test"].column_names,
)
eval_dataset = eval_dataset.rename_columns(
    {
        "masked_input_ids": "input_ids",
        "masked_attention_mask": "attention_mask",
        "masked_labels": "labels",
    }
)
然后我们可以像往常一样设置 DataLoader,但我们将使用🤗 Transformers 中的 default_data_collator 来设置 DataLoader:
from torch.utils.data import DataLoader
from transformers import default_data_collator

batch_size = 64
train_dataloader = DataLoader(
    downsampled_dataset["train"],
    shuffle=True,
    batch_size=batch_size,
    collate_fn=data_collator,
)
eval_dataloader = DataLoader(
    eval_dataset, batch_size=batch_size, collate_fn=default_data_collator
)
从这里开始,我们将遵循🤗 Accelerate 的标准步骤。第一个任务是重新加载预训练模型:
model = AutoModelForMaskedLM.from_pretrained(model_checkpoint)
然后我们需要指定优化器;我们将使用标准的 AdamW :
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=5e-5)
有了这些对象,我们现在可以用 Accelerator 对象包装所有的组件,以进行训练:
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
现在我们的模型、优化器和 DataLoader 都配置好了,我们可以按照以下方式设置学习率调度器:
from transformers import get_scheduler

num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
在开始训练之前,我们还需要做的最后一件事就是在 Hugging Face Hub 上创建一个模型仓库!我们可以使用🤗 Hub 库的 get_full_repo_name,生成我们仓库的全名:
from huggingface_hub import get_full_repo_name

model_name = "distilbert-base-uncased-finetuned-imdb-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'lewtun/distilbert-base-uncased-finetuned-imdb-accelerate'
然后,我们可以使用🤗 Hub 的 Repository 类创建并克隆仓库:
from huggingface_hub import Repository

output_dir = model_name
repo = Repository(output_dir, clone_from=repo_name)
完成后,只需写出完整的训练和评估循环即可:
from tqdm.auto import tqdm
import torch
import math

progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # 训练
    model.train()
    for batch in train_dataloader:
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # 评估
    model.eval()
    losses = []
    for step, batch in enumerate(eval_dataloader):
        with torch.no_grad():
            outputs = model(**batch)

        loss = outputs.loss
        losses.append(accelerator.gather(loss.repeat(batch_size)))

    losses = torch.cat(losses)
    losses = losses[: len(eval_dataset)]
    try:
        perplexity = math.exp(torch.mean(losses))
    except OverflowError:
        perplexity = float("inf")

    print(f">>> Epoch {epoch}: Perplexity: {perplexity}")

    # 保存并上传
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
Epoch 0: Perplexity: 11.397545307900472
Epoch 1: Perplexity: 10.904909330983092
Epoch 2: Perplexity: 10.729503505340409
很棒,我们已经能够评估每个 epoch 的困惑度,并确保运行的结果可以复现!
使用我们微调的模型
你可以使用 Hub 上的模型部件或者在本地使用🤗 Transformers 的 pipeline 加载微调模型预测文本。让我们使用后者通过 fill-mask pipeline 下载我们的模型:
from transformers import pipeline

mask_filler = pipeline(
    "fill-mask", model="huggingface-course/distilbert-base-uncased-finetuned-imdb"
)
然后我们可以将文本“This is a great [MASK]”提供给 pipeline,看看前 5 个预测是什么:
preds = mask_filler(text)

for pred in preds:
    print(f">>> {pred['sequence']}")
'>>> this is a great movie.'
'>>> this is a great film.'
'>>> this is a great story.'
'>>> this is a great movies.'
'>>> this is a great character.'
Nice!—— 我们的模型显然已经调整了它的权重来预测与电影更密切相关的词!
这标志着我们第一次训练语言模型的实验到现在就结束了。在 第 6 节 中,你将学习如何从头开始训练一个自动回归模型,比如 GPT-2;如果你想看看如何预训练你自己的 Transformer 模型,就赶快去那里看看吧!
✏️ 试试看! 为了量化领域适应的好处,分别使用预训练和微调的 DistilBERT checkpoint 以及数据集自带的 IMDb 标签来微调一个分类器,并对比一下这个两个 checkpoint 的差异。如果你需要复习文本分类的知识,请查看 第三章 。
翻译
现在让我们深入研究翻译。这是另一个 sequence-to-sequence 任务 ,着这是一个可以表述为输入是一个序列输出另一个序列的问题。从这个意义上说,这个问题非常类似 文本摘要 ,并且你可以将我们将在此处学习到的一些技巧迁移到其他的序列到序列问题,例如:
- 风格迁移 创建一个模型将某种风格迁移到一段文本(例如,正式的风格迁移到休闲的风格,或从莎士比亚英语迁移到现代英语)。
- 生成问题的回答 创建一个模型,在给定上下文的情况下生成问题的答案。
如果你有足够大的两种(或更多)语言的文本语料库,你可以从头开始训练一个新的翻译模型,就像我们在 因果语言建模 部分中所做的那样。然而,微调现有的翻译模型会更快,无论是从像 mT5 或 mBART 这样的多语言模型微调到特定的语言对,还是从特定语料库的一种语言到另一种语言的专用翻译模型。
在这一节中,我们将在 KDE4 数据集 上微调一个预训练的 Marian 模型,用来把英语翻译成法语的(因为很多 Hugging Face 的员工都会说这两种语言)。KDE4 数据集是一个 KDE 应用 本地化的数据集。我们将使用的模型已经在从 Opus 数据集 (实际上包含 KDE4 数据集)中提取的法语和英语文本的大型语料库上进行了预先训练。不过,即使我们使用的预训练模型在其预训练期间使用了这部分数据集,我们也会看到,经过微调后,我们可以得到一个更好的版本。
完成后,我们将拥有一个模型,可以进行这样的翻译:
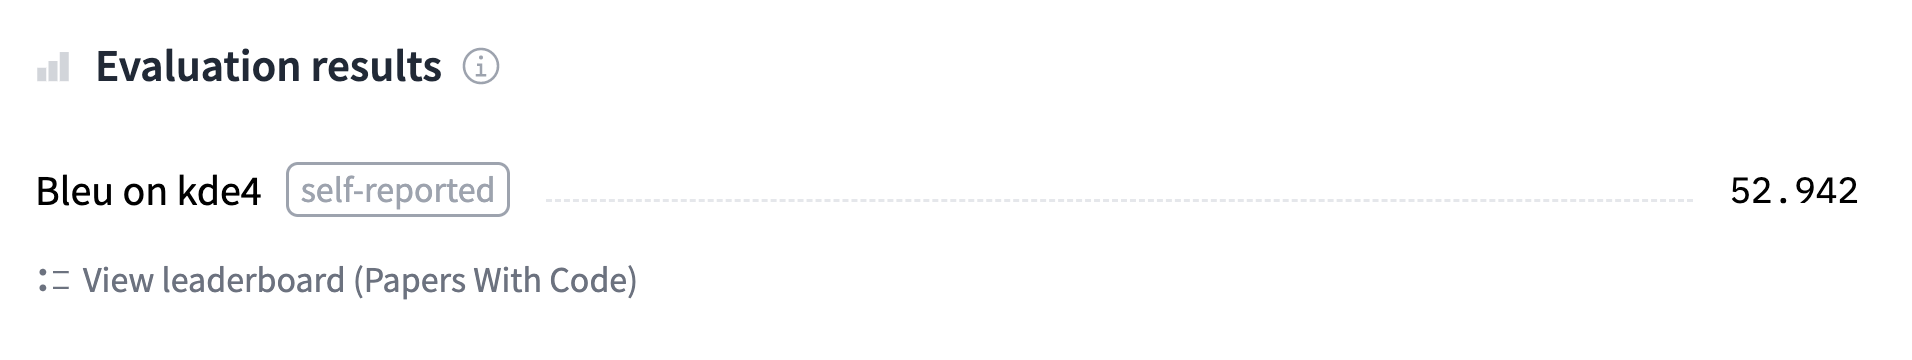
与前面几节一样,你可以使用以下代码找到我们将训练并上传到 Hub 的实际模型,并 在这里 查看模型输出的结果。
准备数据
为了从头开始微调或训练翻译模型,我们需要一个适合该任务的数据集。如前所述,我们将使用 KDE4 数据集 。只要数据集中有互译的两种语言的句子对,就可以很容易地调整本节的代码以使用自己的数据集进行微调。如果你需要复习如何将自定义数据加载到 Dataset ,可以复习一下 第五章 。
KDE4 数据集
像往常一样,我们使用 load_dataset() 函数下载数据集:
from datasets import load_dataset

raw_datasets = load_dataset("kde4", lang1="en", lang2="fr")
如果你想使用其他的语言对,你可以使用语言代码来设置你想使用的语言对。该数据集共有 92 种语言可用;你可以通过展开 数据集卡片 上的语言标签来查看数据集支持的语言标签。
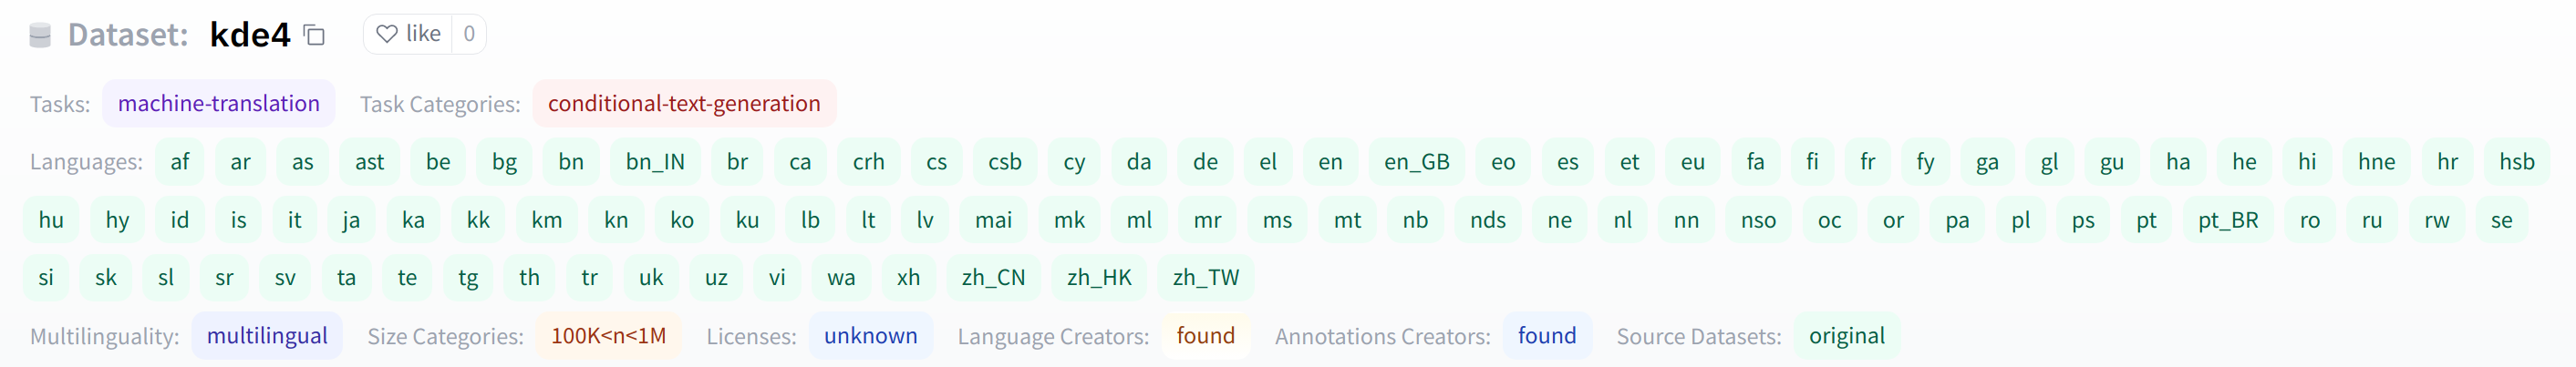
我们来看看数据集:
raw_datasets
DatasetDict({
    train: Dataset({
        features: ['id', 'translation'],
        num_rows: 210173
    })
})
我们下载的数据集有 210,173 对句子,在一次训练过程中,除了训练集,我们也需要创建自己的验证集。正如我们在 第五章 学的的那样, Dataset 有一个 train_test_split() 方法可以帮助我们。我们将设置一个固定的随机数种子以保证结果可以复现:
split_datasets = raw_datasets["train"].train_test_split(train_size=0.9, seed=20)
split_datasets
DatasetDict({
    train: Dataset({
        features: ['id', 'translation'],
        num_rows: 189155
    })
    test: Dataset({
        features: ['id', 'translation'],
        num_rows: 21018
    })
})
我们可以像下面这样将 test 键重命名为 validation:
split_datasets["validation"] = split_datasets.pop("test")
现在让我们看一下数据集的一个元素:
split_datasets["train"][1]["translation"]
{'en': 'Default to expanded threads',
 'fr': 'Par défaut, développer les fils de discussion'}
我们得到一个包含我们选择的两种语言的两个句子的字典。这个充满技术计算机科学术语的数据集的一个特殊之处在于它们都完全用法语翻译。然而现实中,法国工程师在交谈时,大多数计算机科学专用词汇都用英语表述。例如,“threads”这个词很可能出现在法语句子中,尤其是在技术对话中;但在这个数据集中,它被翻译成更准确的“fils de Discussion”。我们使用的预训练模型已经在一个更大的法语和英语句子语料库上进行了预训练,所以输出的是原始的英语表达:
from transformers import pipeline

model_checkpoint = "Helsinki-NLP/opus-mt-en-fr"
translator = pipeline("translation", model=model_checkpoint)
translator("Default to expanded threads")
[{'translation_text': 'Par défaut pour les threads élargis'}]
这种情况的另一个例子可以在“plugin”这个词上看到,它并非正式的法语词汇,但大多数母语是法语的人都能够看懂并且不会去翻译它。不过,在 KDE4 数据集中,这个词被翻译成了更正式的法语词汇“module d’extension”:
split_datasets["train"][172]["translation"]
{'en': 'Unable to import %1 using the OFX importer plugin. This file is not the correct format.',
 'fr': "Impossible d'importer %1 en utilisant le module d'extension d'importation OFX. Ce fichier n'a pas un format correct."}
然而,我们的预训练模型坚持使用简练而熟悉的英文单词:
translator(
    "Unable to import %1 using the OFX importer plugin. This file is not the correct format."
)
[{'translation_text': "Impossible d'importer %1 en utilisant le plugin d'importateur OFX. Ce fichier n'est pas le bon format."}]
看看我们的微调模型是否能学习到数据集的这些特殊特性。(剧透警告:它能)。
✏️ 轮到你了! 另一个在法语中经常使用的英语单词是“email”。在训练数据集中找到使用这个词的第一个样本。在数据集中它是如何翻译的?预训练模型如何翻译同一个英文句子?
处理数据
你现在应该可以预测我们的下一步该做些什么了:将所有文本转换为 token IDs 的集合,这样模型才可以理解它们。对于这个任务,我们需要同时对原始文本和翻译后的文本同时进行 tokenize。首先,我们需要创建 tokenizer 对象。如前所述,我们将使用 Marian 英语到法语的预训练模型。如果你使用下面的代码微调另一对语言,请记得更改下面代码中的 checkpoint。 Helsinki-NLP 组织提供了超过一千个多语言模型。
from transformers import AutoTokenizer

model_checkpoint = "Helsinki-NLP/opus-mt-en-fr"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint, return_tensors="pt")
你也可以将 model_checkpoint 替换为你从 Hub 中选择的其他模型,或者一个保存了预训练模型和 tokenizer 的本地文件夹。
💡 如果你在使用一个多语言的 tokenizer,比如 mBART,mBART-50,或者 M2M100,你需要通过设置
tokenizer.src_lang和tokenizer.tgt_lang来在 tokenizer 中指定输入和目标的语言代码。
我们的数据准备相当简单。只有一点要记住;你需要确保 tokenizer 处理的目标是输出语言(在这里是法语)。你可以通过将目标语言传递给 tokenizer 的 __call__ 方法的 text_targets 参数来完成此操作。
为了演示设置的方法,让我们处理训练集中的一个样本:
en_sentence = split_datasets["train"][1]["translation"]["en"]
fr_sentence = split_datasets["train"][1]["translation"]["fr"]

inputs = tokenizer(en_sentence, text_target=fr_sentence)
inputs
{'input_ids': [47591, 12, 9842, 19634, 9, 0], 'attention_mask': [1, 1, 1, 1, 1, 1], 'labels': [577, 5891, 2, 3184, 16, 2542, 5, 1710, 0]}
我们可以看到,输出包含了与英语句子的 inputs IDs,而与法语句子的 IDs 存储在 labels 字段中。如果你忘记设置 labels 的 tokenizer,默认情况下 labels 将由输入的 tokenizer(语言类型不一样) 进行 tokenize,对于 Marian 模型来说,效果不会很好。
wrong_targets = tokenizer(fr_sentence)
print(tokenizer.convert_ids_to_tokens(wrong_targets["input_ids"]))
print(tokenizer.convert_ids_to_tokens(inputs["labels"]))
['▁Par', '▁dé', 'f', 'aut', ',', '▁dé', 've', 'lop', 'per', '▁les', '▁fil', 's', '▁de', '▁discussion', '</s>']
['▁Par', '▁défaut', ',', '▁développer', '▁les', '▁fils', '▁de', '▁discussion', '</s>']
如你所见,如果用英语的 tokenizer 来预处理法语句子,会产生更多的 tokens,因为这个 tokenizer 不认识任何法语单词(除了那些在英语里也出现的,比如“discussion”)。
最后一步是定义我们数据集的预处理函数:
max_length = 128


def preprocess_function(examples):
    inputs = [ex["en"] for ex in examples["translation"]]
    targets = [ex["fr"] for ex in examples["translation"]]
    model_inputs = tokenizer(
        inputs, text_target=targets, max_length=max_length, truncation=True
    )
    return model_inputs
请注意,上述代码也为输入和输出设置了相同的最大长度。由于要处理的文本看起来很短,因此在这里将最大长度设置为 128。
💡 如果你正在使用 T5 模型(更具体地说,一个
t5-xxxcheckpoint ),模型会期望文本输入有一个前缀指示目前的任务,比如translate: English to French:。
⚠️ 我们不需要对待遇测的目标设置注意力掩码,因为模型序列到序列的不会需要它。不过,我们应该将填充(padding) token 对应的标签设置为
-100,以便在 loss 计算中忽略它们。由于我们正在使用动态填充,这将在稍后由我们的数据整理器完成,但是如果你在此处就打算进行填充,你应该调整预处理函数,将所有填充(padding) token 对应的标签设置为-100。
我们现在可以一次性使用上述预处理处理数据集的所有数据。
tokenized_datasets = split_datasets.map(
    preprocess_function,
    batched=True,
    remove_columns=split_datasets["train"].column_names,
)
现在数据已经过预处理,我们准备好微调我们的预训练模型了!
使用 Trainer API 微调模型
使用 Trainer 的代码将与以前相同,只是稍作改动:我们在这里将使用 Seq2SeqTrainer ,它是 Trainer 的子类,它使用 generate() 方法来预测输入的输出结果,并且可以正确处理这种序列到序列的评估。当我们讨论评估指标时,我们将更详细地探讨这一点。
首先,我们需要一个模型来进行微调。我们将使用常用的 AutoModel API:
from transformers import AutoModelForSeq2SeqLM

model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
注意,这次我们使用的是一个已经在翻译任务上进行过训练的模型,实际上已经可以直接使用了,所以没有收到关于缺少权重或重新初始化的权重的警告。
数据整理
在这个任务中,我们需要一个数据整理器来动态批处理填充。因此,我们不能像 第三章 那样直接使用 DataCollatorWithPadding ,因为它只填充输入的部分(inputs ID、注意掩码和 token 类型 ID)。我们的标签也应该被填充到所有标签中最大的长度。而且,如前所述,用于填充标签的填充值应为 -100 ,而不是 tokenizer 默认的的填充 token,这样才可以在确保在损失计算中忽略这些填充值。
上述的这些需求都可以由 DataCollatorForSeq2Seq 完成。它与 DataCollatorWithPadding 一样,它接收用于预处理输入的 tokenizer ,同时它也接收一个 model 参数。这是因为数据整理器还将负责准备解码器 inputs ID,它们是标签偏移之后形成的,开头带有特殊 token 。由于对于不同的模型架构有稍微不同的偏移方式,所以 DataCollatorForSeq2Seq 还需要接收 model 对象:
from transformers import DataCollatorForSeq2Seq

data_collator = DataCollatorForSeq2Seq(tokenizer, model=model)
为了在几个样本上进行测试,我们在已经完成 tokenize 的训练集中的部分数据上调用它,测试一下其功能:
batch = data_collator([tokenized_datasets["train"][i] for i in range(1, 3)])
batch.keys()
dict_keys(['attention_mask', 'input_ids', 'labels', 'decoder_input_ids'])
我们可以检查我们的标签是否已经用 -100 填充到 batch 的最大长度:
batch["labels"]
tensor([[  577,  5891,     2,  3184,    16,  2542,     5,  1710,     0,  -100,
          -100,  -100,  -100,  -100,  -100,  -100],
        [ 1211,     3,    49,  9409,  1211,     3, 29140,   817,  3124,   817,
           550,  7032,  5821,  7907, 12649,     0]])
我们还可以查看解码器的 inputs ID,可以看到它们是标签经过偏移后的结果:
batch["decoder_input_ids"]
tensor([[59513,   577,  5891,     2,  3184,    16,  2542,     5,  1710,     0,
         59513, 59513, 59513, 59513, 59513, 59513],
        [59513,  1211,     3,    49,  9409,  1211,     3, 29140,   817,  3124,
           817,   550,  7032,  5821,  7907, 12649]])
以下是我们数据集中第一个和第二个元素的标签:
for i in range(1, 3):
    print(tokenized_datasets["train"][i]["labels"])
[577, 5891, 2, 3184, 16, 2542, 5, 1710, 0]
[1211, 3, 49, 9409, 1211, 3, 29140, 817, 3124, 817, 550, 7032, 5821, 7907, 12649, 0]
把 data_collator 传递给 Seq2SeqTrainer 后就完成了数据整理。接下来,让我们看一下评估指标。
评估指标
Seq2SeqTrainer 是 Trainer 类的一个子类,它的主要增强特性是在评估或预测时使用 generate() 方法。在训练过程中,模型会利用 decoder_input_ids 和一个特殊的注意力掩码来加速训练。这种方法允许模型在预测下一个token时看到部分目标序列,但确保它不会使用预测token之后的信息。这种优化策略显著提高了训练效率。然而,在实际的推理过程中,我们没有真实的标签值,因此无法生成 decoder_input_ids 和相应的注意力掩码。这意味着我们无法在推理时使用这种训练时的优化方法。
为了确保评估结果能够准确反映模型在实际使用中的表现,我们应该在评估阶段模拟真实推理的条件。这意味着我们需要使用在 第一章 中介绍的 🤗 Transformers 库中的 generate() 方法。该方法能够逐个生成token,真实地模拟推理过程,而不是依赖于训练时的优化技巧。要启用这个功能,我们需要在训练时添加 predict_with_generate=True 参数。这样做可以确保我们的评估结果更加接近模型在实际应用中的表现。
用于翻译的传统指标是 BLEU 分数 ,它最初由 Kishore Papineni 等人在 2002 年的 一篇文章 中引入。BLEU 分数评估翻译与参考翻译的接近程度。它不衡量模型生成输出的可理解性或语法正确性,而是使用统计规则来确保生成输出中的所有单词也出现在参考的输出中。此外,还有一些规则对重复的词进行惩罚,如果这些词在输出中重复出现(模型输出像“the the the the the”这样的句子);或者输出的句子长度比目标中的短(模型输出像“the”这样的句子)都会被惩罚。
BLEU 的一个缺点是的输入是已分词的文本,这使得比较使用不同分词器的模型之间的分数变得困难。因此,当今用于评估翻译模型的最常用指标是 SacreBLEU ,它通过标准化的分词步骤解决了这个缺点(和其他的一些缺点)。要使用此指标,我们首先需要安装 SacreBLEU 库:
!pip install sacrebleu
然后我们可以就像在 第三章 那样通过 evaluate.load() 加载它
import evaluate

metric = evaluate.load("sacrebleu")
SacreBLEU 指标中待评估的预测和参考的目标译文输入的格式都是文本。它的设计是为了支持多个参考翻译,因为同一句话通常有多种可接受的翻译——虽然我们使用的数据集只提供一个,但在 NLP 中找到将多个句子作为标签的数据集是很常见的。因此,预测结果应该是一个句子列表,而参考应该是一个句子列表的列表。
让我们尝试一个例子:
predictions = [
    "This plugin lets you translate web pages between several languages automatically."
]
references = [
    [
        "This plugin allows you to automatically translate web pages between several languages."
    ]
]
metric.compute(predictions=predictions, references=references)
{'score': 46.750469682990165,
 'counts': [11, 6, 4, 3],
 'totals': [12, 11, 10, 9],
 'precisions': [91.67, 54.54, 40.0, 33.33],
 'bp': 0.9200444146293233,
 'sys_len': 12,
 'ref_len': 13}
达到了 46.75 的 BLEU 分数,这是相当不错的——作为参考,原始 Transformer 模型在 “Attention Is All You Need” 论文 类似的英语和法语翻译任务中获得了 41.8 的 BLEU 分数!(关于其他指标的含义,例如 counts 和 bp ,可以参见 SacreBLEU仓库 )另一方面,如果我们尝试将翻译模型中经常出现的两种糟糕的预测类型(大量重复或太短)输入给指标计算的函数,我们将得到相当糟糕的 BLEU 分数:
predictions = ["This This This This"]
references = [
    [
        "This plugin allows you to automatically translate web pages between several languages."
    ]
]
metric.compute(predictions=predictions, references=references)
{'score': 1.683602693167689,
 'counts': [1, 0, 0, 0],
 'totals': [4, 3, 2, 1],
 'precisions': [25.0, 16.67, 12.5, 12.5],
 'bp': 0.10539922456186433,
 'sys_len': 4,
 'ref_len': 13}
predictions = ["This plugin"]
references = [
    [
        "This plugin allows you to automatically translate web pages between several languages."
    ]
]
metric.compute(predictions=predictions, references=references)
{'score': 0.0,
 'counts': [2, 1, 0, 0],
 'totals': [2, 1, 0, 0],
 'precisions': [100.0, 100.0, 0.0, 0.0],
 'bp': 0.004086771438464067,
 'sys_len': 2,
 'ref_len': 13}
分数可以从 0 到 100,越高越好。
为了将模型的输出转化为评估指标可以使用的文本,我们将使用 tokenizer.batch_decode() 方法。因为 tokenizer 会自动处理填充的 tokens,所以我们只需要清理标签中的所有 -100 token:
import numpy as np


def compute_metrics(eval_preds):
    preds, labels = eval_preds
    # 如果模型返回的内容超过了预测的logits
    if isinstance(preds, tuple):
        preds = preds[0]

    decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)

    # 由于我们无法解码 -100,因此将标签中的 -100 替换掉
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

    # 一些简单的后处理
    decoded_preds = [pred.strip() for pred in decoded_preds]
    decoded_labels = [[label.strip()] for label in decoded_labels]

    result = metric.compute(predictions=decoded_preds, references=decoded_labels)
    return {"bleu": result["score"]}
现在这已经完成了,我们已经准备好微调我们的模型了!
微调模型
第一步是登录 Hugging Face,这样你就可以在训练过程中将结果上传到 Hub中。有一个方便的功能可以帮助你在 notebook 中完成登陆:
from huggingface_hub import notebook_login

notebook_login()
这将显示一个小部件,你可以在其中输入你的 Hugging Face 登录凭据。
如果你不是在 notebook 上运行代码,可以在终端中输入以下命令:
huggingface-cli login
完成这些步骤之后,我们就可以定义我们的 Seq2SeqTrainingArguments 了。与 Trainer 一样,它是 TrainingArguments 的子类,其中包含更多可以设置的字段:
from transformers import Seq2SeqTrainingArguments

args = Seq2SeqTrainingArguments(
    f"marian-finetuned-kde4-en-to-fr",
    evaluation_strategy="no",
    save_strategy="epoch",
    learning_rate=2e-5,
    per_device_train_batch_size=32,
    per_device_eval_batch_size=64,
    weight_decay=0.01,
    save_total_limit=3,
    num_train_epochs=3,
    predict_with_generate=True,
    fp16=True,
    push_to_hub=True,
)
除了通常的超参数(如学习率、训练轮数、批次大小和一些权重衰减)之外,这里的部分参数与我们在前面章节看到的有一些不同:
- 我们没有设置定期进行评估,因为评估需要耗费一定的时间;我们将只在训练开始之前和结束之后评估我们的模型一次。
- 我们设置
fp16=True,这可以加快在支持 fp16 的 GPU 上的训练速度。 - 和之前我们讨论的一样,我们设置
predict_with_generate=True。 - 我们设置了
push_to_hub=True,在每个 epoch 结束时将模型上传到 Hub。
请注意,你可以使用 hub_model_id 参数指定要推送到的存储库的名称(当你想把模型推送到指定的组织的时候,就必须使用此参数)。例如,当我们将模型推送到 huggingface-course 组织 时,我们在 Seq2SeqTrainingArguments 添加了 hub_model_id="huggingface-course/marian-finetuned-kde4-en- to-fr" 。默认情况下,该仓库将保存在你的账户中,并以你设置的输出目录命名,因此在我们的例子中它是 "sgugger/marian-finetuned-kde4-en-to-fr" 。
💡如果你使用的输出目录已经存在一个同名的文件夹,则它应该是推送的仓库克隆在本地的版本。如果不是,你将在定义你的
Seq2SeqTrainer名称时会遇到错误,并且需要设置一个新名称。
最后,我们将所有内容传递给 Seq2SeqTrainer :
from transformers import Seq2SeqTrainer

trainer = Seq2SeqTrainer(
    model,
    args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)
在开始训练之前,我们先查看一下我们的模型目前的 BLEU 分数,以确保我们的微调并未使情况变得更糟。这个命令需要一些时间,所以你可以在执行期间去喝杯咖啡:
trainer.evaluate(max_length=max_length)
{'eval_loss': 1.6964408159255981,
 'eval_bleu': 39.26865061007616,
 'eval_runtime': 965.8884,
 'eval_samples_per_second': 21.76,
 'eval_steps_per_second': 0.341}
BLEU 得分为 39 并不算太差,这反映了我们的模型已经擅长将英语句子翻译成法语句子。
接下来是训练,这也需要一些时间:
trainer.train()
请注意,在训练过程中,每当保存模型时(这里是每个 epoch),它都会在后台将模型上传到 Hub。这样,如有必要,你将能够在另一台机器上继续你的训练。
训练完成后,我们再次评估我们的模型——希望我们会看到 BLEU 分数有所提高!
trainer.evaluate(max_length=max_length)
{'eval_loss': 0.8558505773544312,
 'eval_bleu': 52.94161337775576,
 'eval_runtime': 714.2576,
 'eval_samples_per_second': 29.426,
 'eval_steps_per_second': 0.461,
 'epoch': 3.0}
可以看到近 14 点的改进,这很棒!
最后,我们使用 push_to_hub() 方法来确保我们上传了模型最新的版本。 Trainer 还创建了一张包含所有评估结果的模型卡片并上传到 Hub 。这个模型卡片包含了可以帮助 Hub 为推理演示选择小部件的元数据,通常情况下我们不需要做额外的更改,因为它可以从模型类中推断出正确的小部件,但在这个示例中,它只能通过模型类推断这是一个序列到序列的问题,所以我们补充一下具体的模型类别。
trainer.push_to_hub(tags="translation", commit_message="Training complete")
如果你想检查命令执行的结果,此命令将返回它刚刚执行的提交的 URL,你可以打开 url 进行检查:
'https://huggingface.co/sgugger/marian-finetuned-kde4-en-to-fr/commit/3601d621e3baae2bc63d3311452535f8f58f6ef3'
在此阶段,你可以在 Model Hub 上使用推理小部件来测试你的模型,并与你的朋友分享。你已经成功地在翻译任务上进行了模型的微调,恭喜你!
如果你想更深入地了解训练循环,我们现在将向你展示如何使用 🤗 Accelerate 做同样的事情。
自定义训练循环
我们现在来看一下完整的训练循环,这样你就可以轻松定制你需要的部分。它将与我们在 第 2 节 和 第 3 节 中做的非常相似。
准备训练所需的一切
由于这里的步骤在之前的章节已经出现过很多次,因此这里只做简略说明。首先,我们将数据集设置为 torch 格式,这样可以将数据集的格式转换为 PyTorch 张量,然后我们用数据集构建 DataLoader :
from torch.utils.data import DataLoader

tokenized_datasets.set_format("torch")
train_dataloader = DataLoader(
    tokenized_datasets["train"],
    shuffle=True,
    collate_fn=data_collator,
    batch_size=8,
)
eval_dataloader = DataLoader(
    tokenized_datasets["validation"], collate_fn=data_collator, batch_size=8
)
接下来我们重新实例化我们的模型,以确保我们不会继续上一节的微调,而是再次从预训练模型开始重新训练:
model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
然后我们需要一个优化器:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=2e-5)
准备好这些对象,我们就可以将它们发送到 accelerator.prepare() 方法中。请记住,如果你想在 Colab Notebook 上使用 TPU 进行训练,你需要将所有这些代码移动到一个训练函数中,并且这个训练函数不应该包含实例化 Accelerator 的代码。换句话说,Accelerator 的实例化应该在这个函数之外进行。这么做的原因是,TPU 在 Colab 中的工作方式有些特殊。TPU 运行时会重新执行整个单元格的代码,因此如果 Accelerator 的实例化在训练函数内部,它可能会被多次实例化,导致错误。
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
现在我们已经将我们的 train_dataloader 发送到 accelerator.prepare() 方法中了,现在我们可以使用它的长度来计算训练步骤的数量。请记住,我们应该始终在准备好数据加载器后再执行此操作,因为更改数据加载器会改变 DataLoader 的长度。然后,我们使用学习率衰减到 0 的经典线性学习率调度:
from transformers import get_scheduler

num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
最后,为了将我们的模型推送到 Hugging Face Hub,我们需要在一个工作文件夹中创建一个 Repository 对象。如果你尚未登录 Hugging Face,请先进行登录。我们将根据模型 ID 来确定仓库名称。你可以使用自己选择的名称替换 repo_name,但请确保包含你的用户名。如果你不确定当前的用户名,可以使用get_full_repo_name() 函数来查看:
from huggingface_hub import Repository, get_full_repo_name

model_name = "marian-finetuned-kde4-en-to-fr-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/marian-finetuned-kde4-en-to-fr-accelerate'
然后我们可以在本地文件夹中克隆该存储库。如果已经存在一个同名的文件夹,这个本地文件夹应该是我们正在使用的存储库克隆到本地的版本:
output_dir = "marian-finetuned-kde4-en-to-fr-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
现在,我们可以通过调用 repo.push_to_hub() 方法上传我们在 output_dir 中保存的所有文件。这将帮助我们在每个 epoch 结束时上传中间模型。
训练循环
我们现在准备编写完整的训练循环。为了简化其评估部分,我们定义了这个 postprocess() 函数用于接收预测值和参考翻译对于的标签值,并将其转换为 metric 对象所需要的字符串列表。:
def postprocess(predictions, labels):
    predictions = predictions.cpu().numpy()
    labels = labels.cpu().numpy()

    decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)

    # 替换标签中的 -100,因为我们无法解码它们。
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

    # 一些简单的后处理
    decoded_preds = [pred.strip() for pred in decoded_preds]
    decoded_labels = [[label.strip()] for label in decoded_labels]
    return decoded_preds, decoded_labels
训练循环看起来和本章 第 2 节 与 第三章 中代码很相似,只是在评估部分有一些不同 —— 所以让我们重点关注一下这一点!
首先要注意的是,我们使用 generate() 方法来计算预测,但这是我们基础模型上的一个方法,而不是🤗 Accelerate 在 prepare() 方法中创建的封装模型。这就是为什么我们首先 unwrap_model ,然后调用此方法。
首先要注意的是,我们用来计算预测的 generate() 函数是基础模型上的一个方法,而不是🤗 Accelerate 在 prepare() 函数中创建的封装模型。这就是在调用此函数之前先调用unwrap_model,的原因。
第二个要注意的是,就像 token 分类 一样,在训练和评估这两个过程可能以不同的形状对输入和标签进行了填充,所以我们在调用 gather() 函数之前使用 accelerator.pad_across_processes() 方法,使预测和标签具有相同的形状。如果我们不这么做,那么评估的过程将会出错或被永远挂起。
from tqdm.auto import tqdm
import torch

progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # 训练
    model.train()
    for batch in train_dataloader:
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # 评估
    model.eval()
    for batch in tqdm(eval_dataloader):
        with torch.no_grad():
            generated_tokens = accelerator.unwrap_model(model).generate(
                batch["input_ids"],
                attention_mask=batch["attention_mask"],
                max_length=128,
            )
        labels = batch["labels"]

        # 需要填充预测和标签才能调用gather()
        generated_tokens = accelerator.pad_across_processes(
            generated_tokens, dim=1, pad_index=tokenizer.pad_token_id
        )
        labels = accelerator.pad_across_processes(labels, dim=1, pad_index=-100)

        predictions_gathered = accelerator.gather(generated_tokens)
        labels_gathered = accelerator.gather(labels)

        decoded_preds, decoded_labels = postprocess(predictions_gathered, labels_gathered)
        metric.add_batch(predictions=decoded_preds, references=decoded_labels)

    results = metric.compute()
    print(f"epoch {epoch}, BLEU score: {results['score']:.2f}")

    # 保存和上传
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
epoch 0, BLEU score: 53.47
epoch 1, BLEU score: 54.24
epoch 2, BLEU score: 54.44
训练完成之后,你就有了一个模型,最终的 BLEU 分数应该与 Seq2SeqTrainer 训练的模型非常相似。你可以在 huggingface-course/marian-finetuned-kde4-en-to-fr-accelerate 上查看我们使用此代码训练的模型。如果你想测试对训练循环的任何调整,你可以直接通过编辑上面的代码来实现!
使用微调后的模型
我们已经向你展示了如何在模型 Hub 上使用我们微调的模型。要在本地的 pipeline 中使用它,我们只需要指定正确的模型标识符:
from transformers import pipeline

# 将其替换成你自己的 checkpoint
model_checkpoint = "huggingface-course/marian-finetuned-kde4-en-to-fr"
translator = pipeline("translation", model=model_checkpoint)
translator("Default to expanded threads")
[{'translation_text': 'Par défaut, développer les fils de discussion'}]
和预想的一样,我们的预训练模型适应了我们微调它的语料库,没有保留英语单词“threads”,而是将它翻译成官方的法语版本。对于“plugin”也是如此:
translator(
    "Unable to import %1 using the OFX importer plugin. This file is not the correct format."
)
[{'translation_text': "Impossible d'importer %1 en utilisant le module externe d'importation OFX. Ce fichier n'est pas le bon format."}]
这是另一个领域适应的好例子!
✏️ 轮到你了! 把之前找到的包含单词“email”样本输入模型,会返回什么结果?
提取文本摘要
在本节中,我们将看看如何使用 Transformer 模型将长篇文档压缩为摘要,这项任务称为文本摘要。这是最具挑战性的自然语言处理(NLP)任务之一,因为它需要一系列能力,例如理解长篇文章并且生成能够捕捉文档中主要主题的连贯文本。但是,如果做得好,文本摘要是一种强大的工具,可以减轻各个领域的人详细阅读长文档的负担,从而加快业务流程。
尽管在 Hugging Face Hub 上已经存在各种提取文本摘要的微调模型,但是几乎所有的这些模型都只适用于英文文档。因此,为了在本节中添加一些不一样的特点,我们将为英语和西班牙语训练一个双语模型。在本节结束时,你将有一个可以总结客户评论的 模型 。
如果你试一试的话,就发现模型能够生成非常简洁的摘要,因为它们是从客户在产品评论中提供的标题中学到的。让我们首先为这项任务准备一个合适的双语语料库。
准备多语言语料库
我们将使用 多语言亚马逊评论语料库 创建我们的双语摘要器。该语料库由六种语言的亚马逊产品评论组成,通常用于多语言分类器的基准测试。然而,由于每条评论都附有一个简短的标题,我们可以使用标题作为我们模型学习的参考摘要!首先,让我们从 Hugging Face Hub 下载英语和西班牙语子集:
from datasets import load_dataset

spanish_dataset = load_dataset("amazon_reviews_multi", "es")
english_dataset = load_dataset("amazon_reviews_multi", "en")
english_dataset
DatasetDict({
    train: Dataset({
        features: ['review_id', 'product_id', 'reviewer_id', 'stars', 'review_body', 'review_title', 'language', 'product_category'],
        num_rows: 200000
    })
    validation: Dataset({
        features: ['review_id', 'product_id', 'reviewer_id', 'stars', 'review_body', 'review_title', 'language', 'product_category'],
        num_rows: 5000
    })
    test: Dataset({
        features: ['review_id', 'product_id', 'reviewer_id', 'stars', 'review_body', 'review_title', 'language', 'product_category'],
        num_rows: 5000
    })
})
如你所见,在英语数据集的 train 部分有 200,000 条评论, validation 和 test 部分有 5,000 条评论。我们感兴趣的评论正文和标题保存在 review_body 和 review_title 列中。让我们通过创建一个简单的函数来从训练集中随机抽取一些样本,该函数使用我们在 第五章 学到过:
def show_samples(dataset, num_samples=3, seed=42):
    sample = dataset["train"].shuffle(seed=seed).select(range(num_samples))
    for example in sample:
        print(f"\n'>> Title: {example['review_title']}'")
        print(f"'>> Review: {example['review_body']}'")


show_samples(english_dataset)
'>> Title: Worked in front position, not rear'
'>> Review: 3 stars because these are not rear brakes as stated in the item description. At least the mount adapter only worked on the front fork of the bike that I got it for.'

'>> Title: meh'
'>> Review: Does it’s job and it’s gorgeous but mine is falling apart, I had to basically put it together again with hot glue'

'>> Title: Can\'t beat these for the money'
'>> Review: Bought this for handling miscellaneous aircraft parts and hanger "stuff" that I needed to organize; it really fit the bill. The unit arrived quickly, was well packaged and arrived intact (always a good sign). There are five wall mounts-- three on the top and two on the bottom. I wanted to mount it on the wall, so all I had to do was to remove the top two layers of plastic drawers, as well as the bottom corner drawers, place it when I wanted and mark it; I then used some of the new plastic screw in wall anchors (the 50 pound variety) and it easily mounted to the wall. Some have remarked that they wanted dividers for the drawers, and that they made those. Good idea. My application was that I needed something that I can see the contents at about eye level, so I wanted the fuller-sized drawers. I also like that these are the new plastic that doesn\'t get brittle and split like my older plastic drawers did. I like the all-plastic construction. It\'s heavy duty enough to hold metal parts, but being made of plastic it\'s not as heavy as a metal frame, so you can easily mount it to the wall and still load it up with heavy stuff, or light stuff. No problem there. For the money, you can\'t beat it. Best one of these I\'ve bought to date-- and I\'ve been using some version of these for over forty years.'
✏️ 试试看! 更改
Dataset.shuffle()命令中的随机种子以探索语料库中的其他评论。如果你是说西班牙语的人,请查看spanish_dataset中的一些评论,看看标题是否像是合理的摘要。
这个示例显示了人们通常在网上评论的多样性,从积极的到消极的(以及介于两者之间的评论!)。尽管带有“meh”标题的示例的信息量不大,但其他标题看起来像是对评论本身的不错的总结。在单个 GPU 上训练所有 400,000 条评论的摘要模型将花费太长时间,因此我们将专注于为单个产品领域生成摘要。为了了解我们可以选择哪些领域,让我们将 english_dataset 转换为 pandas.DataFrame ,并计算每个产品类别的评论数量:
english_dataset.set_format("pandas")
english_df = english_dataset["train"][:]
# 显示前 20 个产品的数量
english_df["product_category"].value_counts()[:20]
home                      17679
apparel                   15951
wireless                  15717
other                     13418
beauty                    12091
drugstore                 11730
kitchen                   10382
toy                        8745
sports                     8277
automotive                 7506
lawn_and_garden            7327
home_improvement           7136
pet_products               7082
digital_ebook_purchase     6749
pc                         6401
electronics                6186
office_product             5521
shoes                      5197
grocery                    4730
book                       3756
Name: product_category, dtype: int64
在英语数据集中,最受欢迎的产品是家居用品、服装和无线电子产品。不过,为了带有亚马逊的特色,让我们专注于总结书籍的评论——毕竟,这是亚马逊这家公司成立的基础!我们可以看到两个符合要求的产品类别( book 和 digital_ebook_purchase ),所以让我们用这两个产品类别过滤两种语言的数据集。正如我们在 第五章 学到的, Dataset.filter() 函数可以让我们非常有效地对数据集进行切片,所以我们可以定义一个简单的函数来进行此操作:
def filter_books(example):
    return (
        example["product_category"] == "book"
        or example["product_category"] == "digital_ebook_purchase"
    )
当我们使用这个函数对 english_dataset 和 spanish_dataset 过滤后,结果将只包含涉及书籍类别的那些行。在使用过滤器之前,让我们将 english_dataset 的格式从 "pandas" 切换回 "arrow" :
english_dataset.reset_format()
然后我们可以使用过滤器功能,作为一个基本的检查,让我们检查一些评论的样本,看看它们是否确实与书籍有关:
spanish_books = spanish_dataset.filter(filter_books)
english_books = english_dataset.filter(filter_books)
show_samples(english_books)
'>> Title: I\'m dissapointed.'
'>> Review: I guess I had higher expectations for this book from the reviews. I really thought I\'d at least like it. The plot idea was great. I loved Ash but, it just didnt go anywhere. Most of the book was about their radio show and talking to callers. I wanted the author to dig deeper so we could really get to know the characters. All we know about Grace is that she is attractive looking, Latino and is kind of a brat. I\'m dissapointed.'

'>> Title: Good art, good price, poor design'
'>> Review: I had gotten the DC Vintage calendar the past two years, but it was on backorder forever this year and I saw they had shrunk the dimensions for no good reason. This one has good art choices but the design has the fold going through the picture, so it\'s less aesthetically pleasing, especially if you want to keep a picture to hang. For the price, a good calendar'

'>> Title: Helpful'
'>> Review: Nearly all the tips useful and. I consider myself an intermediate to advanced user of OneNote. I would highly recommend.'
好吧,我们可以看到评论并不是严格意义上的书籍,也可能是指日历和 OneNote 等电子应用程序等内容。尽管如此,该领域似乎也适合训练摘要模型。在我们查筛选适合此任务的各种模型之前,我们还有最后一点数据准备要做:将英文和西班牙文评论作为单个 DatasetDict 对象组合起来。🤗 Datasets 提供了一个方便的 concatenate_datasets() 函数,它(名如其实)将把两个 Dataset 对象堆叠在一起。因此,为了创建我们的双语数据集,我们将遍历数据集的每个部分,并打乱结果以确保我们的模型不会过度拟合单一语言:
from datasets import concatenate_datasets, DatasetDict

books_dataset = DatasetDict()

for split in english_books.keys():
    books_dataset[split] = concatenate_datasets(
        [english_books[split], spanish_books[split]]
    )
    books_dataset[split] = books_dataset[split].shuffle(seed=42)

# 挑选一些样例
show_samples(books_dataset)
'>> Title: Easy to follow!!!!'
'>> Review: I loved The dash diet weight loss Solution. Never hungry. I would recommend this diet. Also the menus are well rounded. Try it. Has lots of the information need thanks.'

'>> Title: PARCIALMENTE DAÑADO'
'>> Review: Me llegó el día que tocaba, junto a otros libros que pedí, pero la caja llegó en mal estado lo cual dañó las esquinas de los libros porque venían sin protección (forro).'

'>> Title: no lo he podido descargar'
'>> Review: igual que el anterior'
这的确看起来像是混合了英语和西班牙语的评论!现在我们有了一个训练语料库,最后要检查的一件事是评论及其标题中单词的分布。这对于摘要任务尤其重要,其中数据中如果出现大量参考摘要过于简短会使模型偏向于生成的摘要中仅有一两个单词。下面的图中显示了单词分布,我们可以看到有些标题严重偏向于 1-2 个单词:

为了解决这个问题,我们将过滤掉标题非常短的示例,以便我们的模型可以生成更有效的摘要。由于我们正在处理英文和西班牙文文本,因此我们可以使用粗略的启发式方法在空白处拆分标题的单词,然后用我们强大的 Dataset.filter() 方法如下:
books_dataset = books_dataset.filter(lambda x: len(x["review_title"].split()) > 2)
现在我们已经准备好了我们的语料库,让我们来看看一些可以对其进行微调的可选的 Transformer 模型!
文本摘要模型
如果你仔细想想,文本摘要是一种类似于机器翻译的任务:我们有一个像评论这样的文本正文,我们希望将其“翻译”成一个较短的版本,同时捕捉到输入文本的主要特征。因此,大多数用于文本摘要的 Transformer 模型采用了我们在 第一章 遇到的编码器-解码器架构。尽管有一些例外,例如 GPT 系列模型,它们在 few-shot(少量微调)之后也可以提取摘要。下表列出了一些可以进行摘要微调的流行预训练模型。
| Transformer 模型 | 描述 | 多种言? |
|---|---|---|
| GPT-2 | 虽然训练为自回归语言模型,但你可以通过在输入文本末尾附加“TL;DR”来使 GPT-2 生成摘要。 | ❌ |
| PEGASUS | 在预训练时的目标是来预测多句子文本中的屏蔽句子。这个预训练目标比普通语言建模更接近文本摘要,并且在流行的基准测试中得分很高。 | ❌ |
| T5 | 通用的 Transformer 架构,所有任务都以文本到文本的框架进行描述;例如,模型文本摘要的输入格式是 summarize: ARTICLE 。 | ❌ |
| mT5 | T5 的多语言版本,在多语言 Common Crawl 语料库 (mC4) 上进行预训练,涵盖了 101 种语言。 | ✅ |
| BART | 一种新颖的 Transformer 架构,其中包含经过训练的编码器和解码器堆栈,以重建被破坏的输入,结合了 BERT 和 GPT-2 的预训练方案。 | ❌ |
| mBART-50 | BART 的多语言版本,预训练了 50 种语言。 | ✅ |
从此表中可以看出,大多数用于摘要的 Transformer 模型(以及大多数 NLP 任务)都是单一语言的。如果你的任务所使用的语言是“有大量语料库”(如英语或德语)的语言,这很好。但对于世界各地正在使用的数千种其他语言,则不然。幸运的是,有一类多语言 Transformer 模型,如 mT5 和 mBART,可以解决问题。这些模型也是使用因果语言建模进行预训练的,但有一点不同:它们不是在一种语言的语料库上训练,而是同时在 50 多种语言的文本上进行联合训练!
我们将使用 mT5,这是一种基于 T5 的有趣架构,在文本到文本任务中进行了预训练。在 T5 中,每个 NLP 任务都是以任务前缀(如 summarize: )的形式定义的,模型根据不同的任务生成不同的文本。如下图所示,这让 T5 变得非常通用,因为你可以用一个模型解决很多任务!

mT5 不使用前缀,但具有 T5 的大部分功能,并且具有多语言的优势。现在我们已经选择了一个模型,接下来让我们来看看如何准备我们的训练数据。
✏️ 试试看! 完成本节后,可以尝试比较一下 mT5 和用相同技术微调过的 mBART 的性能。附加的挑战:只在英文评论上微调 T5。因为 T5 有一个特殊的前缀提示,你需要在下面的预处理步骤中将
summarize:添加到输入例子前。
预处理数据
我们接下来的任务是对我们的评论及其标题进行 tokenize 和 encode 。通常,我们需要首先加载与预训练模型 checkpoint 相关的 tokenizer,这次我们将使用较小的 mt5-small 作为我们的 checkpoint 这样我们就可以在合理的时间消耗内对模型进行微调:
from transformers import AutoTokenizer

model_checkpoint = "google/mt5-small"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
💡在 NLP 项目的早期阶段,一个好的做法是在小样本数据上训练一类“小”模型。这使你可以更快地调试和迭代端到端工作流。当你对结果有信心之后,你只需要通过简单地更改模型 checkpoint 就可以在较大规模数据上训练模型!
让我们在一个小样本上测试 mT5 tokenizer
inputs = tokenizer("I loved reading the Hunger Games!")
inputs
{'input_ids': [336, 259, 28387, 11807, 287, 62893, 295, 12507, 1], 'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 1]}
在这里我们可以看到熟悉的 input_ids 和 attention_mask ,我们在 第3章 的第一次微调实验中遇到过。让我们使用 tokenizer 的 convert_ids_to_tokens() 函数解码这些输入 ID,看看我们正在处理的是什么类型的 tokenizer:
tokenizer.convert_ids_to_tokens(inputs.input_ids)
['▁I', '▁', 'loved', '▁reading', '▁the', '▁Hung', 'er', '▁Games', '</s>']
从特殊的 Unicode 字符 ▁ 和表示序列结束 </s> token 可以看出来,我们正在使用基于 第6章 中讨论的 Unigram 子词分词算法的 SentencePiece tokenizer 。 Unigram 对于多语言语料库特别有用,因为它让 SentencePiece 不必受口音、标点符号以及很多语言(如日语)没有空白字符的影响,只专注于找出最优的分词方式。
为了对我们的语料库 tokenize ,我们需要处理与摘要任务会遇到的一个细微问题:因为我们的输出目标也是文本,所以输入和输出加起来可能超过模型的最大上下文大小。这意味着我们需要对评论及其标题进行截断,以确保我们不会将过长的输入传递给我们的模型。🤗 Transformers 中的 tokenizer 提供了一个绝妙的 text_target 参数,允许你将目标文本与输入并行 tokenize。以下是如何为 mT5 处理输入和目标文本的示例:
max_input_length = 512
max_target_length = 30


def preprocess_function(examples):
    model_inputs = tokenizer(
        examples["review_body"],
        max_length=max_input_length,
        truncation=True,
    )
    labels = tokenizer(
        examples["review_title"], max_length=max_target_length, truncation=True
    )
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
让我们逐步解析这段代码,理解发生了什么。我们首先定义了 max_input_length 和 max_target_length 的值,这些值设定了我们的评论和标题的最大长度。由于评论主体通常比标题大得多,我们相应地调整了这些值。
通过 preprocess_function() 函数,我们可以使用我们在这门课程中广泛使用的方便的 Dataset.map() 函数,轻松地对整个语料库 tokenize 。
tokenized_datasets = books_dataset.map(preprocess_function, batched=True)
既然语料库已经预处理完毕,我们来看看一些常用的摘要指标。正如我们在下面即将看到的,在衡量机器生成的文本的质量方面没有灵丹妙药。
💡 你可能已经注意到我们在上面的
Dataset.map()函数中使用了batched=True。这将以 1000(默认值)的 batch size 对示例继续编码,并让你可以利用 🤗 Transformers 中快速 tokenizer 的多线程功能。在可能的情况下,尝试使用batched=True来加速你的预处理!
文本摘要的评估指标
与我们在本课程中涵盖的大多数其他任务相比,衡量文本生成任务(如摘要或翻译)的好坏并不那么简单。例如,对于“我喜欢阅读饥饿游戏”这样的评论,可能有多个有效摘要,例如“我喜欢饥饿游戏”或“饥饿游戏是一本好书”。显然,在生成的摘要和标签之间进行某种精确匹配并不是一个好的解决方案——即使是人类在这样的评估指标下也会表现不佳,因为每个人都有自己的写作风格。
总而言之,最常用的指标之一是ROUGE 分数(Recall-Oriented Understudy for Gisting Evaluation 的缩写)。该指标背后的基本思想是将生成的摘要与一组通常由人类创建的参考摘要进行比较。更具体地说,假设我们要比较以下两个摘要:
generated_summary = "I absolutely loved reading the Hunger Games"
reference_summary = "I loved reading the Hunger Games"
比较它们的一种方法是计算重叠单词的数量,在这个例子中为 6。然而,这种方法有些粗糙,因此 ROUGE 是基于计算计算重叠部分的 精确度(Precision) 和 召回率(Recall) 分数来计算的。
🙋 如果这是你第一次听说精确度(Precision)和召回率(Recall),请不要担心——我们将一起通过一些清晰的示例来理解它们。这些指标通常在分类任务中遇到,所以如果你想了解在分类任务中精确度(Precision)和召回率(Recall)是如何定义的,我们建议你查看
scikit-learn的 指南 。
对于 ROUGE,召回率衡量的是参考摘要中被生成摘要捕获的内容量。如果我们只是比较单词,召回率可以按照以下公式计算:召回率=重叠词的数量参考摘要中的总词数召回率=参考摘要中的总词数重叠词的数量
对于上面的那个例子,这个公式给出了 6/6 = 1 的完美召回率;即,参考摘要中的所有单词模型都生成出来了。这听起来可能很棒,但想象一下,如果我们生成的摘要是“我真的很喜欢整晚阅读饥饿游戏”。这也会有完美的 recall,但可以说这是一个更糟糕的总结,因为它很冗长。为了适应于这些场景,我们还计算了精确度,它在 ROUGE 上下文中衡量了生成的摘要中有多少是相关的:精确度=重叠词的数量生成摘要中的总词数精确度=生成摘要中的总词数重叠词的数量
详细摘要使用这种计算方法会得到 6/10 = 0.6 的精确度,这比较短的摘要获得的 6/7 = 0.86 的精确度要差得多。在实践中,通常会先计算计算精度和召回率,然后得到 F1 分数(精确度和召回率的调和平均数)。我们可以很容易地在🤗 Datasets 中通过安装 rouge_score 包来实现这些计算:
!pip install rouge_score
然后按如下方式加载 ROUGE 指标:
import evaluate

rouge_score = evaluate.load("rouge")
接着我们可以使用 rouge_score.compute() 函数来一次性计算所有的指标:
scores = rouge_score.compute(
    predictions=[generated_summary], references=[reference_summary]
)
scores
{'rouge1': AggregateScore(low=Score(precision=0.86, recall=1.0, fmeasure=0.92), mid=Score(precision=0.86, recall=1.0, fmeasure=0.92), high=Score(precision=0.86, recall=1.0, fmeasure=0.92)),
 'rouge2': AggregateScore(low=Score(precision=0.67, recall=0.8, fmeasure=0.73), mid=Score(precision=0.67, recall=0.8, fmeasure=0.73), high=Score(precision=0.67, recall=0.8, fmeasure=0.73)),
 'rougeL': AggregateScore(low=Score(precision=0.86, recall=1.0, fmeasure=0.92), mid=Score(precision=0.86, recall=1.0, fmeasure=0.92), high=Score(precision=0.86, recall=1.0, fmeasure=0.92)),
 'rougeLsum': AggregateScore(low=Score(precision=0.86, recall=1.0, fmeasure=0.92), mid=Score(precision=0.86, recall=1.0, fmeasure=0.92), high=Score(precision=0.86, recall=1.0, fmeasure=0.92))}
哇,这个输出中包含了很多信息——它们都代表什么意思呢?首先,🤗 Datasets 计算了精度、召回率和 F1 分数的置信区间;也些就是你在这里看到的 low 、 mid 和 high 属性。此外,🤗 Datasets 还计算了基于在比较生成摘要和参考摘要时的采用不同文本粒度的各种 ROUGE 得分。 rouge1 测量的是生成摘要和参考摘要中单个单词的重叠程度。 为了验证这一点,让我们提取出我们得分的 mid 值:
scores["rouge1"].mid
Score(precision=0.86, recall=1.0, fmeasure=0.92)
太好了,精确度和召回率的数字都对上了!那么其他的 ROUGE 得分表示什么含义呢? rouge2 度量了二元词组(考虑单词对的重叠)之间的重叠,而 rougeL 和 rougeLsum 通过寻找生成的摘要和参考摘要中最长的公共子串来度量单词的最长匹配序列。 rougeLsum 中的“sum”指的是该指标是在整个摘要上计算的,而 rougeL 是指在各个句子上计算的平均值。
✏️ 试试看! 自己手动创建一个生成摘要和参考摘要,看看使用 evaluate 得出的 ROUGE 分数是否与基于精确度和召回率公式的手动计算一致。附加的挑战:将文本切分为长度为2的词组,并手动计算精度和召回率与
rouge2指标的精确度和召回率进行对比。
我们将使用这些 ROUGE 分数来跟踪我们模型的性能,但在此之前,让我们做每个优秀的 NLP 从业者都应该做的事情:创建一个强大而简单的 baseline!
创建强大的 baseline
对于文本摘要,一个常见的参考 baseline 是简单地取文章的前三句话作为摘要,通常称为 lead-3 baseline。我们可以使用句号(英文使用.)来跟踪句子边界,但这在“U.S.” or “U.N.”之类的首字母缩略词上会计算错误。所以我们将使用 nltk 库,它包含一个更好的算法来处理这些情况。你可以使用以下方式安装该包:
!pip install nltk
然后下载标点规则:
import nltk

nltk.download("punkt")
接下来,我们从 nltk 导入句子的 tokenizer 并创建一个简单的函数用来提取评论中的前三个句子。文本摘要的默认情况下使用换行符分隔每个摘要,因此我们也按照这样的规则处理,并在训练集的示例上对其进行测试:
from nltk.tokenize import sent_tokenize


def three_sentence_summary(text):
    return "\n".join(sent_tokenize(text)[:3])


print(three_sentence_summary(books_dataset["train"][1]["review_body"]))
'I grew up reading Koontz, and years ago, I stopped,convinced i had "outgrown" him.'
'Still,when a friend was looking for something suspenseful too read, I suggested Koontz.'
'She found Strangers.'
这似乎有效,接下来让我们现在实现一个函数,从数据集中提取这些“摘要”并计算 baseline 的 ROUGE 分数:
def evaluate_baseline(dataset, metric):
    summaries = [three_sentence_summary(text) for text in dataset["review_body"]]
    return metric.compute(predictions=summaries, references=dataset["review_title"])
然后我们可以使用这个函数来计算验证集上的 ROUGE 分数,并使用 Pandas 对输出的结果进行一些美化:
import pandas as pd

score = evaluate_baseline(books_dataset["validation"], rouge_score)
rouge_names = ["rouge1", "rouge2", "rougeL", "rougeLsum"]
rouge_dict = dict((rn, round(score[rn].mid.fmeasure * 100, 2)) for rn in rouge_names)
rouge_dict
{'rouge1': 16.74, 'rouge2': 8.83, 'rougeL': 15.6, 'rougeLsum': 15.96}
我们可以看到 rouge2 的分数明显低于其他的rouge;这可能反映了这样一个事实,即评论标题通常很简洁,因此 lead-3 baseline 过于冗长导致得分不高。现在我们有了一个很好的参考基准,让我们将注意力转向微调 mT5!
使用 Trainer API 微调 mT5
微调模型来提取摘要与我们在本章中介绍的其他任务非常相似。我们需要做的第一件事是从 mt5-small checkpoint 中加载预训练模型。由于摘要提取是一个序列到序列的任务,我们可以使用 AutoModelForSeq2SeqLM 类加载模型,该类会自动下载并缓存模型权重:
from transformers import AutoModelForSeq2SeqLM

model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
💡 如果你想知道为什么在实例化的过程中没有看到任何关于微调模型的警告,那是因为对于序列到序列的任务,我们保留了网络的所有权重。与此相比,在 第三章 中的文本分类模型中,我们用一个随机初始化的网络替换了预训练模型的头部。
我们需要做的下一件事是登录 Hugging Face Hub。如果你在 notebook 中运行此代码,则可以使用以下实用程序函数进行此操作:
from huggingface_hub import notebook_login

notebook_login()
这将显示一个小工具,你可以在其中输入你的凭据。或者,你可以在你的终端运行这条命令来登陆:
huggingface-cli login
为了在训练期间计算 ROUGE 分数,我们需要在训练期间生成文本形式的摘要。幸运的是,🤗 Transformers 提供了专用的 Seq2SeqTrainingArguments 和 Seq2SeqTrainer 类,可以自动为我们完成这项工作!为了了解它是如何工作的,让我们首先为我们的实验定义超参数和其他参数,在后面的的训练过程会讲到如何实现的。
from transformers import Seq2SeqTrainingArguments

batch_size = 8
num_train_epochs = 8
# 每个训练周期都输出训练损失
logging_steps = len(tokenized_datasets["train"]) // batch_size
model_name = model_checkpoint.split("/")[-1]

args = Seq2SeqTrainingArguments(
    output_dir=f"{model_name}-finetuned-amazon-en-es",
    evaluation_strategy="epoch",
    learning_rate=5.6e-5,
    per_device_train_batch_size=batch_size,
    per_device_eval_batch_size=batch_size,
    weight_decay=0.01,
    save_total_limit=3,
    num_train_epochs=num_train_epochs,
    predict_with_generate=True,
    logging_steps=logging_steps,
    push_to_hub=True,
)
在上面的代码中,我们把 predict_with_generate 参数设置为 True ,这样可以在评估期间生成摘要来计算每个 epoch 的 ROUGE 分数。正如在 第一章 中学到的,模型的 generate() 函数实现了使用解码器逐个预测单词来推理生成的文本。设置 predict_with_generate=True 后,Seq2SeqTrainer 会在评估时使用 generate() 函数。除此之外我们还调整默认的超参数,如学习率、epochs 数和权重衰减,并且设置 save_total_limit 选项, 使训练期间最多只能保存 3 个 checkpoint 的选项。——这是因为即使是 mT5 的“small”版本也使用大约 1 GB 的硬盘空间,我们可以通过限制保存的副本数量来节省一点空间。
设置 push_to_hub=True 选项后 Trainer 会在训练后自动将模型推送到 Hub 中;你可以在 output_dir 指定的位置下的用户配置文件中找到对应的仓库。请注意,你可以使用 hub_model_id 参数指定要推送到的仓库的名称(特别是当你想要推送到组织时,就必须使用此参数)。例如,当我们将模型推送到 huggingface-course 组织 时,我们在 Seq2SeqTrainingArguments 中添加了 hub_model_id="huggingface-course/mt5-finetuned-amazon-en-es" 。
为了在训练期间评估模型,我们还需要为 Trainer 提供一个 compute_metrics() 函数。对于摘要模型来说,不能直接调用 rouge_score.compute() 进行评估,因为我们需要将输出和参考摘要解码为文本,然后才能计算 ROUGE 分数。下面的函数就完成了解码和计算分数,除此之外还使用了 nltk 中的 sent_tokenize() 函数将摘要句子用换行符分隔开:
import numpy as np


def compute_metrics(eval_pred):
    predictions, labels = eval_pred
    # 将生成的摘要解码为文本
    decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)
    # 替换标签中的-100,因为我们无法解码它们
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    # 将参考摘要解码为文本
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
    # ROUGE期望每个句子后都有一个换行符
    decoded_preds = ["\n".join(sent_tokenize(pred.strip())) for pred in decoded_preds]
    decoded_labels = ["\n".join(sent_tokenize(label.strip())) for label in decoded_labels]
    # 计算ROUGE分数
    result = rouge_score.compute(
        predictions=decoded_preds, references=decoded_labels, use_stemmer=True
    )
    # 计算ROUGE分数
    result = {key: value.mid.fmeasure * 100 for key, value in result.items()}
    return {k: round(v, 4) for k, v in result.items()}
接下来,我们需要为我们的序列到序列任务定义一个数据整理器(data collator)。由于 mT5 是一个编码器-解码器的 Transformer 模型,因此在将数据整理成 batch 时有一点需要注意,那就是在解码期间,我们需要将标签向右移动一个单位。这是为了确保解码器只看到之前的参考序列,而不是当前要预测的 token 或之后的参考序列,这样模型就能避免容易记住标签。这类似与在 因果语言模型 这样的任务中使用掩码自注意力的机制类似。
幸运的是,🤗 Transformers 提供了一个 DataCollatorForSeq2Seq 整理器,它会动态地填充我们的输入和标签。我们只需要提供 tokenizer 和 model 既可实例化这个整理器:
from transformers import DataCollatorForSeq2Seq

data_collator = DataCollatorForSeq2Seq(tokenizer, model=model)
让我们看看当给这个整理器提供一个小批次的样本时,它的处理过程是怎么样的。首先,我们需要删除带有字符串的列,因为整理器不知道如何对这些元素进行填充(padding):
tokenized_datasets = tokenized_datasets.remove_columns(
    books_dataset["train"].column_names
)
由于 collator 需要一个 dict 的列表,其中每个 dict 代表数据集中的一个样本,所以我们也需要在将数据传给数据整理器之前,将数据整理成预期的格式:
features = [tokenized_datasets["train"][i] for i in range(2)]
data_collator(features)
{'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
         1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0],
        [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
         1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]]), 'input_ids': tensor([[  1494,    259,   8622,    390,    259,    262,   2316,   3435,    955,
            772,    281,    772,   1617,    263,    305,  14701,    260,   1385,
           3031,    259,  24146,    332,   1037,    259,  43906,    305,    336,
            260,      1,      0,      0,      0,      0,      0,      0],
        [   259,  27531,  13483,    259,   7505,    260, 112240,  15192,    305,
          53198,    276,    259,  74060,    263,    260,    459,  25640,    776,
           2119,    336,    259,   2220,    259,  18896,    288,   4906,    288,
           1037,   3931,    260,   7083, 101476,   1143,    260,      1]]), 'labels': tensor([[ 7483,   259,  2364, 15695,     1,  -100],
        [  259, 27531, 13483,   259,  7505,     1]]), 'decoder_input_ids': tensor([[    0,  7483,   259,  2364, 15695,     1],
        [    0,   259, 27531, 13483,   259,  7505]])}
首先要注意的是,第二个例子比第一个例子要长,所以第一个例子的 input_ids 和 attention_mask 在右边用 [PAD] token (ID 为 0 )进行了填充。同样,我们可以看到标签也使用 -100 进行了填充,以确保填充的 tokens 被损失函数忽略。最后,我们可以看到多了一个新的 decoder_input_ids 字段,它是通过在第一个条目中插入 [PAD] tokens 来将标签向右移动一个 token 形成的。
我们终于拥有了训练所需的所有的前期准备!我们现在只需要使用标准参数实例化 Trainer
from transformers import Seq2SeqTrainer

trainer = Seq2SeqTrainer(
    model,
    args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)
然后启动我们的训练:
trainer.train()
在训练期间,应该可以看到训练损失逐渐减小,并且 ROUGE 分数随着 epoch 的增加而增加。训练完成之后,你可以通过运行 Trainer.evaluate() 来查看最后的 ROUGE 分数:
trainer.evaluate()
{'eval_loss': 3.028524398803711,
 'eval_rouge1': 16.9728,
 'eval_rouge2': 8.2969,
 'eval_rougeL': 16.8366,
 'eval_rougeLsum': 16.851,
 'eval_gen_len': 10.1597,
 'eval_runtime': 6.1054,
 'eval_samples_per_second': 38.982,
 'eval_steps_per_second': 4.914}
从分数中我们可以看到,我们的模型轻松超过了我们的 lead-3 baseline——很好!最后要做的是将模型权重推送到 Hub,如下所示:
trainer.push_to_hub(commit_message="Training complete", tags="summarization")
'https://huggingface.co/huggingface-course/mt5-finetuned-amazon-en-es/commit/aa0536b829b28e73e1e4b94b8a5aacec420d40e0'
上面的代码会把 checkpoint 和配置文件保存到 output_dir ,然后将所有文件上传到 Hub。我们还可以通过 tags 参数指定模型的类型,这样就可以确保在 Hub 上的小工具会是一个摘要生成的小工具,而不是与 mT5 架构的默认文本生成小工具(关于模型标签的更多信息,请参见 🤗Hub文档 )。 trainer.push_to_hub() 的输出是带有 Git 提交哈希的 URL,所以你可以打开 URL 轻松查看模型库的修改记录!
在结束本节之前,让我们看一下如何使用 🤗 Accelerate 提供的底层 API 对 mT5 进行微调。
使用 🤗 Accelerate 微调 mT5
使用 🤗 Accelerate 微调我们的模型与我们在 第三章 中遇到的文本分类示例非常相似。与文本分类的主要区别在于摘要模型需要在训练期间显式生成摘要并实现 ROUGE 分数的计算(请记住, Seq2SeqTrainer 已经为我们实现了生成摘要的部分)。让我们看看我们如何在 🤗 Accelerate 中实现这两个要求!
为训练做好准备
首先,我们需要为每个数据分组创建一个 DataLoader 。由于 PyTorch 的 dataloaders 的输入是由张量组成的 batch,所以我们需要将数据集的格式设定为 "torch" :
tokenized_datasets.set_format("torch")
然后我们可以实例化数据整理器,并使用它来定义我们的 DataLoader:
from torch.utils.data import DataLoader

batch_size = 8
train_dataloader = DataLoader(
    tokenized_datasets["train"],
    shuffle=True,
    collate_fn=data_collator,
    batch_size=batch_size,
)
eval_dataloader = DataLoader(
    tokenized_datasets["validation"], collate_fn=data_collator, batch_size=batch_size
)
接下来,我们需要定义我们要使用的优化器。与我们的其他例子一样,我们将使用 AdamW ,这个优化器大多数场景下都很有效:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=2e-5)
为了重新开始微调,而不是从上面微调过的模型继续微调,我们需要重新实例化 model。
model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
最后,我们将模型、优化器和 dataloaders 输入到 accelerator.prepare() 方法中:
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
🚨如果你在 TPU 上进行训练,则需要将上述所有代码移动到专门的训练函数中。有关 TPU 的详细信息,请回顾 第三章 。
现在我们已经准备好了我们的对象,还有三个事情需要做
- 定义学习率调度计划。
- 实现一个功能来对模型输出的摘要进行后续处理以进行评估。
- 在 Hub 上创建一个模型仓库,我们可以将模型推送到该仓库。
对于学习率调度,我们将使用前几节中的标准线性衰减:
from transformers import get_scheduler

num_train_epochs = 10
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
对于后续处理,我们需要一个函数,将生成的摘要拆分为由换行符分隔的句子。这是 ROUGE 指标需要的输入格式,我们可以使用以下代码片段来实现:
def postprocess_text(preds, labels):
    preds = [pred.strip() for pred in preds]
    labels = [label.strip() for label in labels]

    # ROUGE 需要每个句子后有一个换行符
    preds = ["\n".join(nltk.sent_tokenize(pred)) for pred in preds]
    labels = ["\n".join(nltk.sent_tokenize(label)) for label in labels]

    return preds, labels
如果你还记得我们是如何定义 Seq2SeqTrainer 的 compute_metrics() 函数,那么你应该对上述的代码来感到很熟悉。
最后,我们需要在 Hugging Face Hub 上创建一个模型仓库。为此,我们可以使用名为🤗 Hub 的 python 库。我们只需要为我们的仓库取一个 ID,Hub 库中有一个实用的函数可以将仓库 ID 与用户 ID 组合起来:
from huggingface_hub import get_full_repo_name

model_name = "test-bert-finetuned-squad-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'lewtun/mt5-finetuned-amazon-en-es-accelerate'
现在我们可以将这个仓库克隆到模型保存的路径中,该目录将存储训练生成的文件:
from huggingface_hub import Repository

output_dir = "results-mt5-finetuned-squad-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
这样,我们就可以在训练期间通过调用 repo.push_to_hub() 方法将模型推送到 Hub!现在让我们通过写出完整的训练循环来结束我们的分析。
训练循环
文本摘要的训练循环与我们遇到的其他 🤗 Accelerate 示例非常相似,大致分为四个主要步骤:
- 通过在每个 epoch 迭代
train_dataloader中的所有示例来训练模型。 - 在每个 epoch 结束时生成摘要,首先生成 tokens 然后将它们(和参考摘要)解码为文本。
- 使用我们之前的方法计算 ROUGE 分数。
- 保存 checkpoint 并将所有内容推送到 Hub。在这里,我们依赖
Repository对象的巧妙的blocking=False参数,以便我们可以在每个 epoch 异步地上传 checkpoint,这使我们能够继续训练,而不必等待与 GB 大小的模型慢呼呼的上传!
这些步骤可以在以下代码块中看到:
from tqdm.auto import tqdm
import torch
import numpy as np

progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # 训练
    model.train()
    for step, batch in enumerate(train_dataloader):
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # 评估
    model.eval()
    for step, batch in enumerate(eval_dataloader):
        with torch.no_grad():
            generated_tokens = accelerator.unwrap_model(model).generate(
                batch["input_ids"],
                attention_mask=batch["attention_mask"],
            )

            generated_tokens = accelerator.pad_across_processes(
                generated_tokens, dim=1, pad_index=tokenizer.pad_token_id
            )
            labels = batch["labels"]

            # 如果我们没有填充到最大长度,我们需要填充标签
            labels = accelerator.pad_across_processes(
                batch["labels"], dim=1, pad_index=tokenizer.pad_token_id
            )

            generated_tokens = accelerator.gather(generated_tokens).cpu().numpy()
            labels = accelerator.gather(labels).cpu().numpy()

            # 替换标签中的 -100,因为我们无法解码它们
            labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
            if isinstance(generated_tokens, tuple):
                generated_tokens = generated_tokens[0]
            decoded_preds = tokenizer.batch_decode(
                generated_tokens, skip_special_tokens=True
            )
            decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

            decoded_preds, decoded_labels = postprocess_text(
                decoded_preds, decoded_labels
            )

            rouge_score.add_batch(predictions=decoded_preds, references=decoded_labels)

    # 计算评估的 loss
    result = rouge_score.compute()
    # 提取中位 ROUGE 分数
    result = {key: value.mid.fmeasure * 100 for key, value in result.items()}
    result = {k: round(v, 4) for k, v in result.items()}
    print(f"Epoch {epoch}:", result)

    # 保存和上传
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
Epoch 0: {'rouge1': 5.6351, 'rouge2': 1.1625, 'rougeL': 5.4866, 'rougeLsum': 5.5005}
Epoch 1: {'rouge1': 9.8646, 'rouge2': 3.4106, 'rougeL': 9.9439, 'rougeLsum': 9.9306}
Epoch 2: {'rouge1': 11.0872, 'rouge2': 3.3273, 'rougeL': 11.0508, 'rougeLsum': 10.9468}
Epoch 3: {'rouge1': 11.8587, 'rouge2': 4.8167, 'rougeL': 11.7986, 'rougeLsum': 11.7518}
Epoch 4: {'rouge1': 12.9842, 'rouge2': 5.5887, 'rougeL': 12.7546, 'rougeLsum': 12.7029}
Epoch 5: {'rouge1': 13.4628, 'rouge2': 6.4598, 'rougeL': 13.312, 'rougeLsum': 13.2913}
Epoch 6: {'rouge1': 12.9131, 'rouge2': 5.8914, 'rougeL': 12.6896, 'rougeLsum': 12.5701}
Epoch 7: {'rouge1': 13.3079, 'rouge2': 6.2994, 'rougeL': 13.1536, 'rougeLsum': 13.1194}
Epoch 8: {'rouge1': 13.96, 'rouge2': 6.5998, 'rougeL': 13.9123, 'rougeLsum': 13.7744}
Epoch 9: {'rouge1': 14.1192, 'rouge2': 7.0059, 'rougeL': 14.1172, 'rougeLsum': 13.9509}
就是这样!运行此程序后,你将获得与我们使用“Trainer”获得的模型和结果非常相似的模型和结果。
使用你微调的模型
将模型推送到 Hub 后,你可以通过推理小部件或 pipeline 对象来使用它,如下所示:
from transformers import pipeline

hub_model_id = "huggingface-course/mt5-small-finetuned-amazon-en-es"
summarizer = pipeline("summarization", model=hub_model_id)
我们可以将测试集(模型还没有见过的一些数据)中取一些样本提供给我们的管道,来感受一下生成的摘要的质量。首先让我们实现一个简单的函数,同时显示评论、标题和生成的摘要:
def print_summary(idx):
    review = books_dataset["test"][idx]["review_body"]
    title = books_dataset["test"][idx]["review_title"]
    summary = summarizer(books_dataset["test"][idx]["review_body"])[0]["summary_text"]
    print(f"'>>> Review: {review}'")
    print(f"\n'>>> Title: {title}'")
    print(f"\n'>>> Summary: {summary}'")
让我们看一下其中一个英文摘要的例子:
print_summary(100)
'>>> Review: Nothing special at all about this product... the book is too small and stiff and hard to write in. The huge sticker on the back doesn’t come off and looks super tacky. I would not purchase this again. I could have just bought a journal from the dollar store and it would be basically the same thing. It’s also really expensive for what it is.'

'>>> Title: Not impressed at all... buy something else'

'>>> Summary: Nothing special at all about this product'
这还不错!我们可以看到,我们的模型实际上已经能够通过增加部分新词来生成总结的摘要了。我们模型最酷的方面是它是双语的,所以我们还可以生成西班牙语评论的摘要:
print_summary(0)
'>>> Review: Es una trilogia que se hace muy facil de leer. Me ha gustado, no me esperaba el final para nada'

'>>> Title: Buena literatura para adolescentes'

'>>> Summary: Muy facil de leer'
在这个例子中生成的摘要翻译成中文的意思是“非常容易阅读”,我们可以看到它是直接从评论中提取的。同时,这个例子还展现了mT5 模型的多种功能特性,并支持处理多语言的语料库!
接下来,我们将尝试一个稍微复杂一点的任务:从头开始训练一个语言模型。
从头开始训练因果语言模型
到目前为止,我们主要使用预训练模型,并通过复用预训练的权重,然后使用新的数据对它们进行微调,以适应新的应用场景。正如我们在 第一章 中看到的,这通常称为 迁移学习(transfer learning) ,对于大多数标注数据稀缺的应用场景,它是一种将 Transformer 模型应用到大部分真实的应用场景中的一个非常成功的策略。在本章中,我们将采用不同的方法并从头开始训练一个全新的模型。如果你有大量数据而且这些数据与可用模型的预训练数据差异很大,那么这是一个很好的方法。然而,相比仅微调现有模型,预训练语言模型需要更多的计算资源。训练一个新模型可能是有意义的示例包括由音乐符号、DNA 等分子序列或编程语言组成的数据集。编程语言组成的数据集最近广泛地受到关注,这要归功于 TabNine 和 GitHub 的 Copilot 等工具的流行,它们由 OpenAI 的 Codex 模型提供支持,可以生成长代码序列。这种文本生成任务最适合使用自回归或因果语言模型(例如 GPT-2)。
在这一节,我们将构建一个精简版的代码生成模型:使用 Python 代码的一个数据集,来实现一行代码的补全,而不是直接生成完整的函数或类。当你使用 Python 处理数据时,你经常会接触到 Python 数据科学栈,包括 matplotlib , seaborn , pandas ,和 scikit-learn 这些库。当使用这些框架时,经常需要查找特定的命令,如果我们能够用模型来自动给出恰当的推荐命令就太好了!
在 第六章 中,我们创建了一个高效的 tokenizer 来处理 Python 源代码,但我们还需要一个大规模的数据集来预训练模型。在这里,我们将使用 tokenizer 处理一个来自 GitHub 仓库的 Python 代码语料库。然后,我们将使用 Trainer API 和 🤗 Accelerate 来训练模型。让我们开始吧!
这里展示的是一个已经训练并上传到 Hub 的模型,它就是使用本节中的代码训练的。你可以在 [这里](https://huggingface.co/huggingface-course/codeparrot-ds?text=plt.imshow() 找到它。注意,由于文本生成过程中有一些随机性,你可能会得到稍微不同的结果。
收集数据
我们可以从诸如 GitHub 这样的代码仓库中获取丰富的 Python 代码,通过对每个 Python 仓库进行抓取,我们就可以创建一个数据集。这就是在 Transformers textbook 中预训练一个大型 GPT-2 模型的方法。开发者整理了名为 codeparrot 的一个大约为 180GB 的 GitHub 数据集, 其中包含大约 2,000 万个的Python 文件。 开发者用这些文件构建了一个数据集,并在 Hugging Face Hub 上分享了这个数据集。
然而,使用完整语料库的训练既耗时又费力,我们只需要找到 Python 数据科学栈相关的数据集子集。所以,让我们从 codeparrot 数据集中筛选出包含这个栈中所有相关库的所有文件。由于数据集的太大,我们希望避免直接把全部的数据集下载下来;因此,我们将使用流式传输的方法来动态过滤它。为了使用上述的库来筛选代码样本,我们将使用以下函数:
def any_keyword_in_string(string, keywords):
    for keyword in keywords:
        if keyword in string:
            return True
    return False
让我们用两个例子来测试一下:
filters = ["pandas", "sklearn", "matplotlib", "seaborn"]
example_1 = "import numpy as np"
example_2 = "import pandas as pd"

print(
    any_keyword_in_string(example_1, filters), any_keyword_in_string(example_2, filters)
)
False True
我们可以使用这个函数来创建一个新的函数,该函数将流式传输数据集并过滤我们想要的元素:
from collections import defaultdict
from tqdm import tqdm
from datasets import Dataset


def filter_streaming_dataset(dataset, filters):
    filtered_dict = defaultdict(list)
    total = 0
    for sample in tqdm(iter(dataset)):
        total += 1
        if any_keyword_in_string(sample["content"], filters):
            for k, v in sample.items():
                filtered_dict[k].append(v)
    print(f"{len(filtered_dict['content'])/total:.2%} of data after filtering.")
    return Dataset.from_dict(filtered_dict)
然后我们可以直接使用这里函数流式处理数据集:
# 执行这个代码块需要非常长的时间,因此你可以跳过它,继续执行下一个!
from datasets import load_dataset

split = "train"  # "valid"
filters = ["pandas", "sklearn", "matplotlib", "seaborn"]

data = load_dataset(f"transformersbook/codeparrot-{split}", split=split, streaming=True)
filtered_data = filter_streaming_dataset(data, filters)
3.26% of data after filtering.
完成这个操作后,我们过滤后的数据集只有原始数据集的大约 3%,但这仍然是相当可观的大小——最终的数据集是 6GB,由 600,000 个 Python 脚本组成!
过滤完整的数据集可能需要 2-3 小时,这取决于你的机器性能和带宽。如果你不想亲自经历这个漫长的过程,我们在 Hub 上提供了过滤后的数据集供你下载:
from datasets import load_dataset, DatasetDict

ds_train = load_dataset("huggingface-course/codeparrot-ds-train", split="train")
ds_valid = load_dataset("huggingface-course/codeparrot-ds-valid", split="validation")

raw_datasets = DatasetDict(
    {
        "train": ds_train,  # .shuffle().select(range(50000)),
        "valid": ds_valid,  # .shuffle().select(range(500))
    }
)

raw_datasets
DatasetDict({
    train: Dataset({
        features: ['repo_name', 'path', 'copies', 'size', 'content', 'license'],
        num_rows: 606720
    })
    valid: Dataset({
        features: ['repo_name', 'path', 'copies', 'size', 'content', 'license'],
        num_rows: 3322
    })
})
让我们看一个来自数据集的例子。我们将只显示每个字段的前 200 个字符:
for key in raw_datasets["train"][0]:
    print(f"{key.upper()}: {raw_datasets['train'][0][key][:200]}")
'REPO_NAME: kmike/scikit-learn'
'PATH: sklearn/utils/__init__.py'
'COPIES: 3'
'SIZE: 10094'
'''CONTENT: """
The :mod:`sklearn.utils` module includes various utilites.
"""

from collections import Sequence

import numpy as np
from scipy.sparse import issparse
import warnings

from .murmurhash import murm
LICENSE: bsd-3-clause'''
我们可以看到, content 字段包含了我们希望模型训练的代码。有了这个数据集之后,我们需要对文本进行一些处理,以便它们适合于预训练。
准备数据集
首先,我们需要将数据进行分词处理,这样才能进行训练。由于我们的主要目标是自动补全短的函数调用,因此我们可以将上下文大小设置得相对较小。这样做的好处是我们可以更快地训练模型,而且需要的内存也大大减少。如果你的应用需要更多的上下文(比如,你希望模型根据包含函数定义的文件编写单元测试),那么应该增大该数字,但是也要记住这会增加 GPU 显存的占用。现在,我们将上下文大小固定为 128 个 tokens 而不是在 GPT-2 或 GPT-3 中使用的 1,024 或 2,048 个 tokens
大多数文档都包含超过 128 个 tokens 因此简单地将输入截断到最大长度会删除我们数据集的很一大部分。因此,我们将使用 return_overflowing_tokens 选项将整个输入进行分词处理,并将其分割为几个块,正如我们在 第六章 中所做的那样。我们还将使用 return_length 选项自动返回创建的每个块的长度。通常,最后一个块的大小会小于上下文大小,我们将去掉最后一块以避免填充问题;因为我们已经有足够的数据,所以不需要它们。

让我们通过查看前两个示例来具体了解结果怎么样:
from transformers import AutoTokenizer

context_length = 128
tokenizer = AutoTokenizer.from_pretrained("huggingface-course/code-search-net-tokenizer")

outputs = tokenizer(
    raw_datasets["train"][:2]["content"],
    truncation=True,
    max_length=context_length,
    return_overflowing_tokens=True,
    return_length=True,
)

print(f"Input IDs length: {len(outputs['input_ids'])}")
print(f"Input chunk lengths: {(outputs['length'])}")
print(f"Chunk mapping: {outputs['overflow_to_sample_mapping']}")
Input IDs length: 34
Input chunk lengths: [128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 117, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 41]
Chunk mapping: [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
我们可以看到,这两个例子总共得到了 34 个块。查看块长度,我们可以看到两个文档末端的块少于 128 个 tokens (分别为 117 和 41)。不过这些只占我们所拥有的总块数的一小部分,因此我们可以放心地丢掉它们。通过 overflow_to_sample_mapping 字段,我们还可以分辨出哪些块属于哪个样本。
在这个操作中,我们使用了🤗 Datasets 中的 Dataset.map() 函数的一个便捷的特性,即它并不需要一对一地设置分块后和分块前的映射关系;正如我们在 第三节 中看到的,我们可以自由地将一个样本拆分或者删除部分样本来创建比输入的 batch_size 更多或更少元素的 batch。 Dataset.map() 函数会自动帮我们关联映射关系,当进行像数据增强或数据过滤这样改变元素数量的操作时非常有用。在我们的情况下,当将每个样本分词并分割成指定上下文大小的块时,我们从每个样本中创建了许多样本。我们需要删除原本的列,因为它们的大小和我们分割后的大小不一样。如果我们想保留它们,我们可以复制它们来填充,并在 Dataset.map() 调用中返回它们。
def tokenize(element):
    outputs = tokenizer(
        element["content"],
        truncation=True,
        max_length=context_length,
        return_overflowing_tokens=True,
        return_length=True,
    )
    input_batch = []
    for length, input_ids in zip(outputs["length"], outputs["input_ids"]):
        if length == context_length:
            input_batch.append(input_ids)
    return {"input_ids": input_batch}


tokenized_datasets = raw_datasets.map(
    tokenize, batched=True, remove_columns=raw_datasets["train"].column_names
)
tokenized_datasets
DatasetDict({
    train: Dataset({
        features: ['input_ids'],
        num_rows: 16702061
    })
    valid: Dataset({
        features: ['input_ids'],
        num_rows: 93164
    })
})
我们现在有 1670 万个样本,每个样本有 128 个 tokens 总共相当于大约 21 亿个 tokens。作为参考,OpenAI 的 GPT-3 和 Codex 模型分别在 300 和 1000 亿个 tokens 上进行了训练,其中 Codex 模型从 GPT-3 checkpoint 初始化。本节的目标不是与这些能生成长且连贯文本的模型竞争,而是创建一个能为数据科学家提供快速自动代码补全功能的精简版本。
既然我们已经准备好了数据集,那就来设置模型吧!
✏️ **试一试!**这里我们删除了所有小于设定的上下文大小的块,并不会造成大问题,因为我们使用的是比较小的上下文窗口。随着增大上下文大小(或者语料库中的文档长度都很短),被抛弃的块的比例也会增加。更有效方法是将所有 tokenize 后的样本拼接起来加入一个 batch 中,每个样本之间有一个
eos_token_idtoken 作为分隔,然后对连接后的序列进行切块处理。作为练习,修改tokenize()函数以利用这种方法。请注意,为了获取完整的 token ID 序列你需要设置truncation=False,并删除 tokenizer 中的其他参数。
初始化一个新模型
我们的第一步是初始化一个全新地 GPT-2 模型。我们可以通过加载预训练配置来初始化一个与 GPT-2 small 相同的配置的模型,并确保 tokenizer 大小与模型的词汇表大小匹配,以及设置 bos 和 eos (序列的开始和结束) token IDs:
from transformers import AutoTokenizer, GPT2LMHeadModel, AutoConfig

config = AutoConfig.from_pretrained(
    "gpt2",
    vocab_size=len(tokenizer),
    n_ctx=context_length,
    bos_token_id=tokenizer.bos_token_id,
    eos_token_id=tokenizer.eos_token_id,
)
有了这个配置对象,我们就可以加载一个全新的 GPT-2 模型。注意,这是我们第一次不使用 from_pretrained() 函数,因为我们实际上是自己初始化一个全新的模型而不是从一个预训练的模型继续训练:
model = GPT2LMHeadModel(config)
model_size = sum(t.numel() for t in model.parameters())
print(f"GPT-2 size: {model_size/1000**2:.1f}M parameters")
GPT-2 size: 124.2M parameters
我们的新模型有 124M 个参数需要训练。在开始训练之前,我们需要设置一个数据整理器(DataCollator),它将负责创建 Batch。我们可以使用 DataCollatorForLanguageModeling ,顾名思义,它专门用于语言建模。除了堆叠和填充创建 Batch 之外,它还负责创建语言模型的待预测的标签 —— 在因果语言建模中,输入就是待预测的标签(只是偏移一个元素),而这个数据整理器(DataCollator)在训练过程中实时将输入偏移一个元素来创建它们,因此我们不需要复制 input_ids 。
注意, DataCollatorForLanguageModeling 同时支持掩码语言建模 (MLM) 和因果语言建模 (CLM)。默认情况下它安装 MLM 需要的格式准备数据,但我们可以通过设置 mlm=False 参数切换到 CLM。
from transformers import DataCollatorForLanguageModeling

tokenizer.pad_token = tokenizer.eos_token
data_collator = DataCollatorForLanguageModeling(tokenizer, mlm=False)
让我们看一个例子:
out = data_collator([tokenized_datasets["train"][i] for i in range(5)])
for key in out:
    print(f"{key} shape: {out[key].shape}")
input_ids shape: torch.Size([5, 128])
attention_mask shape: torch.Size([5, 128])
labels shape: torch.Size([5, 128])
我们可以看到示例的数据已经处理好了,并且所有 tensor 都具有相同的形状。
⚠️ 输入序列和目标序列对齐将在模型内部自动进行,所以数据整理器只需复制输入序列来创建目标序列。
现在我们已经准备好了所有东西,可以开始训练我们的模型了——好像也不是那么困难!在我们开始训练之前,我们应该登录到 Hugging Face。如果你正在使用 Notebook 运行代码,你可以使用下面的实用函数进行登录:
from huggingface_hub import notebook_login

notebook_login()
这将显示一个小部件,你可以在其中输入你的 Hugging Face 登录凭据。
如果你不是在 Notebook 上工作,只需在终端中输入以下行:
huggingface-cli login
剩下要做的就是配置训练参数并启动 Trainer 。本次的训练中我们将使用余弦学习率调度,并进行一些 Warmup。训练的 batch size 是 256 ( per_device_train_batch_size * gradient_accumulation_steps )。当单个 batch 无法放入内存时,可以使用梯度累积,并通过多次向前/向后传递逐步累积梯度。当我们在本节最后使用 🤗 Accelerate 创建训练循环时,我们将看到这一点。
from transformers import Trainer, TrainingArguments

args = TrainingArguments(
    output_dir="codeparrot-ds",
    per_device_train_batch_size=32,
    per_device_eval_batch_size=32,
    evaluation_strategy="steps",
    eval_steps=5_000,
    logging_steps=5_000,
    gradient_accumulation_steps=8,
    num_train_epochs=1,
    weight_decay=0.1,
    warmup_steps=1_000,
    lr_scheduler_type="cosine",
    learning_rate=5e-4,
    save_steps=5_000,
    fp16=True,
    push_to_hub=True,
)

trainer = Trainer(
    model=model,
    tokenizer=tokenizer,
    args=args,
    data_collator=data_collator,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["valid"],
)
现在我们只需启动 Trainer 并等待训练完成。根据你是在整个训练集还是在训练集的一个子集上运行它,这将分别需要 20 或 2 个小时,因此请喝杯咖啡或者找一本好书来阅读!
trainer.train()
训练完成后,我们可以将模型和 tokenizer 推送到 Hub:
trainer.push_to_hub()
✏️ 试试看! 除了
TrainingArguments之外,我们只需要大约 30 行代码就可以从原始文本到训练 GPT-2。用你自己的数据集试试看,看看你能不能得到好的结果!
💡 如果你能使用多 GPU 的机器,尝试在那里运行代码。
Trainer自动管理多台机器,这能极大地加快训练速度。
使用 pipeline 进行代码生成
现在是见证奇迹的时刻:我们来看看训练好的模型到底表现如何!我们可以在日志中看到损失持续下降,但要测试模型的效果,我们就看看它对一些提示的反应如何。为此,我们将模型包装在一个文本生成的 pipeline 中,并如果有 GPU 可用,我们将把它放在 GPU 上加快生成速度:
import torch
from transformers import pipeline

device = torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
pipe = pipeline(
    "text-generation", model="huggingface-course/codeparrot-ds", device=device
)
让我们从简单的创建散点图任务开始:
txt = """\
# 创建一些数据
x = np.random.randn(100)
y = np.random.randn(100)

# 使用 x,y 创建散点图
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# 创建一些数据
x = np.random.randn(100)
y = np.random.randn(100)

# 使用 x,y 创建散点图
plt.scatter(x, y)

# 创建散点
结果看起来是正确的。那么对于 pandas 操作也可以吗?让我们看看是否能从两个数组创建一个 DataFrame :
txt = """\
# 创建一些数据
x = np.random.randn(100)
y = np.random.randn(100)

# 从 x 和 y 创建 dataframe
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# 创建一些数据
x = np.random.randn(100)
y = np.random.randn(100)

# 从 x 和 y 创建 dataframe
df = pd.DataFrame({'x': x, 'y': y})
df.insert(0,'x', x)
for
很好,这是正确的答案——尽管它又把 x 重复插入了一次。而且由于生成的 token 数量有限,所以下面的 for 循环被切断了。让我们看看我们是否能做些更复杂的事情,让模型帮助我们使用 groupby 操作:
txt = """\
# 有职业,收入和名字的 dataframe
df = pd.DataFrame({'profession': x, 'income':y, 'name': z})

# 计算每个职业的平均收入
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# 有职业,收入和名字的 dataframe
df = pd.DataFrame({'profession': x, 'income':y, 'name': z})

# 计算每个职业的平均收入
profession = df.groupby(['profession']).mean()

# 计算
不错;是正确的。最后,让我们看看是否能引导模型使用 scikit-learn 并建立一个随机森林模型:
txt = """
# 从 scikit-learn 导入随机森林回归器
from sklearn.ensemble import RandomForestRegressor

# 用 X, y 拟合带有 300 个估算器的随机森林模型:
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# 从 scikit-learn 导入随机森林回归器
from sklearn.ensemble import RandomForestRegressor

# 用 X, y 拟合带有 300 个估算器的随机森林模型:
rf = RandomForestRegressor(n_estimators=300, random_state=random_state, max_depth=3)
rf.fit(X, y)
rf
从这几个例子来看,模型似乎已经学习了 Python 数据科学堆栈的一些语法(当然,在将模型部署到现实世界之前,我们需要对其进行更全面的评估)。然而,有时候它需要更多的模型训练定制来达到特定情境所需的性能。例如,如果我们想动态更新 batch_size 或添加一个条件训练循环来跳过坏示例怎么办?一种选择是修改 Trainer 添加新的功能,但有时从头开始编写训练循环会更简单。这就是🤗 Accelerate 的用武之地。
使用🤗 Accelerate 进行训练
我们已经看到了如何使用 Trainer 训练模型,在 Trainer 中可以对训练过程可以通过修改一些参数进行一些定制。然而,有时我们想要完全控制训练循环,或者我们想要进行一些更自由的的更改。在这种情况下 🤗 Accelerate 是一个不错的选择,本节我们将介绍如何使用它来训练我们的模型。为了让事情变得更有趣,相比于上面的 Trainer 我们还将在训练循环中添加一些修改。
由于我们主要关注的是为数据科学库提供合理的代码自动补充功能,因此对于更多使用这些库的训练样本赋予更高的权重是有意义的。我们可以通过使用 plt 、 pd 、 sk 、 fit 和 predict 等关键词来轻松地识别出这些例子,这些关键词是 matplotlib.pyplot 、 pandas 和 sklearn 导入后最常用重命名的名称,以及 sklearn 的 fit/predict 方法。如果这些在模型的内部是用单一的一个 token 表示的,我们可以通过 token 的 id 轻松地检查它们是否出现在输入序列中。然而,Tokens 有可能有空格前缀,所以我们也需要在 tokenizer 词汇表中检查这些关键词。为了验证这个策略的有效性,我们会在测试样本中添加一个应该被分割为多个 tokens 的测试 token:
keytoken_ids = []
for keyword in [
    "plt",
    "pd",
    "sk",
    "fit",
    "predict",
    " plt",
    " pd",
    " sk",
    " fit",
    " predict",
    "testtest",
]:
    ids = tokenizer([keyword]).input_ids[0]
    if len(ids) == 1:
        keytoken_ids.append(ids[0])
    else:
        print(f"Keyword has not single token: {keyword}")
'Keyword has not single token: testtest'
太好了,这个方法似乎很有效!我们现在可以编写一个自定义的损失函数,它的输入有输入序列、logits 和我们刚刚选择的关键字。首先需要对齐 logits 和 inputs : 并将输入序列右移一个单位形成目标序列,因为下一个 token 就是当前 token 的预测的目标。我们可以通过从输入序列的第二个 token 开始设置标签,因为模型不会预测第一个 token。然后我们截断最后一个 logit,因为我们没有完整输入序列后面的标签。有了这些,我们就可以计算每个样本的损失,并计算每个样本中所有关键词的出现次数。最后,我们使用出现次数作为权重,计算所有样本的加权平均值。由于我们不想抛弃所有没有关键词的样本,我们将所有的权重都加 1:
from torch.nn import CrossEntropyLoss
import torch


def keytoken_weighted_loss(inputs, logits, keytoken_ids, alpha=1.0):
    # 左移 tokens < n 预测 n
    shift_labels = inputs[..., 1:].contiguous()
    shift_logits = logits[..., :-1, :].contiguous()
    # 计算每一个token的loss
    loss_fct = CrossEntropyLoss(reduce=False)
    loss = loss_fct(shift_logits.view(-1, shift_logits.size(-1)), shift_labels.view(-1))
    # 对于每个样本重新调整大小并平均
    loss_per_sample = loss.view(shift_logits.size(0), shift_logits.size(1)).mean(axis=1)
    # 计算并缩放权重
    weights = torch.stack([(inputs == kt).float() for kt in keytoken_ids]).sum(
        axis=[0, 2]
    )
    weights = alpha * (1.0 + weights)
    # 计算评价权重
    weighted_loss = (loss_per_sample * weights).mean()
    return weighted_loss
在我们开始使用这个精妙的新损失函数进行训练之前,我们需要准备一些事情:
- 我们需要数据加载器来批量加载数据。
- 我们需要设置权重衰减参数。
- 有时我们在调试模型的时候可能需要临时评估,所以将评估代码包装在一个函数中。
让我们从数据加载器开始。我们只需要将数据集的格式设置为 "torch" ,然后我们就可以将它传递给一个具有适当 batch size 的 PyTorch 的 DataLoader :
from torch.utils.data.dataloader import DataLoader

tokenized_datasets.set_format("torch")
train_dataloader = DataLoader(tokenized_datasets["train"], batch_size=32, shuffle=True)
eval_dataloader = DataLoader(tokenized_datasets["valid"], batch_size=32)
接下来,我们将参数分组,以便优化器知道哪些参数需要进行额外的权重衰减。通常,所有的偏置和 LayerNorm 权重项都不需要进行权重衰减;因此我们可以这样做:
weight_decay = 0.1


def get_grouped_params(model, no_decay=["bias", "LayerNorm.weight"]):
    params_with_wd, params_without_wd = [], []
    for n, p in model.named_parameters():
        if any(nd in n for nd in no_decay):
            params_without_wd.append(p)
        else:
            params_with_wd.append(p)
    return [
        {"params": params_with_wd, "weight_decay": weight_decay},
        {"params": params_without_wd, "weight_decay": 0.0},
    ]
我们希望在训练过程中定期在验证集上评估模型,让我们为此编写一个函数。它只需遍历评估数据加载器,并收集所有进程中的损失值:
def evaluate():
    model.eval()
    losses = []
    for step, batch in enumerate(eval_dataloader):
        with torch.no_grad():
            outputs = model(batch["input_ids"], labels=batch["input_ids"])

        losses.append(accelerator.gather(outputs.loss))
    loss = torch.mean(torch.cat(losses))
    try:
        perplexity = torch.exp(loss)
    except OverflowError:
        perplexity = float("inf")
    return loss.item(), perplexity.item()
通过 evaluate() 函数我们定期可以获取损失值和 困惑度(perplexity) 。接下来,我们重新加载我们的模型以确保我们再次从头开始训练,而不是从上面的 Trainer 继续微调:
model = GPT2LMHeadModel(config)
然后我们可以定义我们的优化器,使用之前的函数来分割权重衰减的参数:
from torch.optim import AdamW

optimizer = AdamW(get_grouped_params(model), lr=5e-4)
现在让我们准备模型、优化器和数据加载器,然后我们可以开始训练:
from accelerate import Accelerator

accelerator = Accelerator(fp16=True)

model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
🚨 如果你在 TPU 上训练,你需要将上述单元格开始的所有代码移到一个专门的训练函数中。更多详情请参阅 第三章 。
现在我们已经将我们的 train_dataloader 传递给了 accelerator.prepare() ,我们可以使用 len() 来计算训练步骤的数量。请记住,我们应该在准备好 dataloader 后再使用 len() ,因为改动 dataloader 会改变其长度。我们使用一个从学习率衰减到 0 的经典线性学习率调度:
num_train_epochs = 1
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    name="linear",
    optimizer=optimizer,
    num_warmup_steps=1_000,
    num_training_steps=num_training_steps,
)
最后,为了将我们的模型推送到 Hub,我们需要在一个工作文件夹中创建一个 Repository 对象。如果你还没有登录的话,首先需要登录到 Hugging Face,我们将根据模型 ID 来确定仓库名称(你可以使用你喜欢的名字替换 repo_name ;它只需要包含你的用户名,可以使用 get_full_repo_name() 函数的查看目前的 repo_name):
from huggingface_hub import Repository, get_full_repo_name

model_name = "codeparrot-ds-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/codeparrot-ds-accelerate'
然后我们可以将该仓库克隆到本地文件夹中。如果本地已经存在一个同名的文件夹,这个本地文件夹应该是我们正在使用的仓库的克隆在本地的版本:
output_dir = "codeparrot-ds-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
我们现在可以通过调用 repo.push_to_hub() 方法上传保存在 output_dir 中的所有内容。这将帮助我们在每个训练周期结束时上传中间模型。
evaluate()
(10.934126853942871, 56057.14453125)
目前的损失和困惑度都是非常高的值,但这并不奇怪,因为我们还没有训练模型。到现在为止,我们已经为编写训练脚本的核心部分:训练循环已经做好了准备。在训练循环中,我们迭代遍历数据加载器并将成批量的数据传递给模型。有了模型输出的 logits,我们就可以使用自定义损失函数计算损伤。我们通过梯度累积步骤的数量来缩放损失,以避免在聚合更多步骤时产生更大的损失。在我们优化之前,我们也会剪裁梯度来更好的收敛。最后,每隔一段步数,我们用新的 evaluate() 函数在评估集上评估模型:
from tqdm.notebook import tqdm

gradient_accumulation_steps = 8
eval_steps = 5_000

model.train()
completed_steps = 0
for epoch in range(num_train_epochs):
    for step, batch in tqdm(
        enumerate(train_dataloader, start=1), total=num_training_steps
    ):
        logits = model(batch["input_ids"]).logits
        loss = keytoken_weighted_loss(batch["input_ids"], logits, keytoken_ids)
        if step % 100 == 0:
            accelerator.print(
                {
                    "samples": step * samples_per_step,
                    "steps": completed_steps,
                    "loss/train": loss.item() * gradient_accumulation_steps,
                }
            )
        loss = loss / gradient_accumulation_steps
        accelerator.backward(loss)
        if step % gradient_accumulation_steps == 0:
            accelerator.clip_grad_norm_(model.parameters(), 1.0)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()
            completed_steps += 1
        if (step % (eval_steps * gradient_accumulation_steps)) == 0:
            eval_loss, perplexity = evaluate()
            accelerator.print({"loss/eval": eval_loss, "perplexity": perplexity})
            model.train()
            accelerator.wait_for_everyone()
            unwrapped_model = accelerator.unwrap_model(model)
            unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
            if accelerator.is_main_process:
                tokenizer.save_pretrained(output_dir)
                repo.push_to_hub(
                    commit_message=f"Training in progress step {step}", blocking=False
                )
就是这样 - 你现在拥有自己的因果语言模型(例如 GPT-2)的自定义训练循环,你可以根据自己的需要进一步定制。
✏️ 试试看! 创建适合你的用例的自定义损失函数,或在训练循环中添加另一个自定义步骤。
✏️ 试试看! 当运行长时间的训练实验时,使用 TensorBoard 或 Weights & Biases 等工具记录重要指标是个好主意。向训练循环中添加适当的日志记录,这样你可以随时检查训练进度。
抽取式问答问答
现在我们来看看问答这个任务!这个任务有很多种类型,但我们在本节将要关注的是称为 抽取式(extractive) 问题回答的形式。会有一些问题和文档,其中答案就在文档段落之内。
我们将使用 SQuAD 数据集 微调一个 BERT 模型,其中包括群众工作者对一组维基百科文章提出的问题。以下是一个小的测试样例:
本节使用的代码已经上传到了 Hub。你可以在 这里 找到它并尝试用它进行预测。
💡 像 BERT 这样的纯编码器模型往往很擅长提取诸如 “谁发明了 Transformer 架构?”之类的事实性问题的答案。但在给出诸如 “为什么天空是蓝色的?” 之类的开放式问题时表现不佳。在这些更具挑战性的情况下,通常使用编码器-解码器模型如 T5 和 BART 来以类似于 文本摘要 的方式整合信息。如果你对这种
生成式(generative)问答感兴趣,我们推荐你查看我们做的基于 ELI5 数据集 的 演示demo 。
准备数据
作为抽取式问题回答的学术基准最常用的数据集是 SQuAD ,所以我们在这里将使用它。还有一个更难的 SQuAD v2 基准,其中包含一些没有答案的问题。你也可以使用自己的数据集,只要你自己的数据集包含了 Context 列、问题列和答案列,应该也能够适用下面的步骤。
SQuAD 数据集
像往常一样,我们可以使用 load_dataset() 在一行中下载和缓存数据集:
from datasets import load_dataset

raw_datasets = load_dataset("squad")
我们可以查看这个 raw_datasets 对象来了解关于 SQuAD 数据集的更多信息:
raw_datasets
DatasetDict({
    train: Dataset({
        features: ['id', 'title', 'context', 'question', 'answers'],
        num_rows: 87599
    })
    validation: Dataset({
        features: ['id', 'title', 'context', 'question', 'answers'],
        num_rows: 10570
    })
})
看起来我们的数据集拥有所需的 context 、 question 和 answers 字段,所以让我们打印训练集的第一个元素:
print("Context: ", raw_datasets["train"][0]["context"])
print("Question: ", raw_datasets["train"][0]["question"])
print("Answer: ", raw_datasets["train"][0]["answers"])
Context: 'Architecturally, the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend "Venite Ad Me Omnes". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette Soubirous in 1858. At the end of the main drive (and in a direct line that connects through 3 statues and the Gold Dome), is a simple, modern stone statue of Mary.'
Question: 'To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France?'
Answer: {'text': ['Saint Bernadette Soubirous'], 'answer_start': [515]}
context 和 question 字段的使用非常直观。 answers 字段相对复杂一些,因为它是一个字典,包含两个列表的字段。这是在评估时 squad 指标需要的格式;如果你使用的是你自己的数据,不需要将答案处理成完全相同的格式。 text 字段是非常明显的答案文本,而 answer_start 字段包含了 Context 中每个答案开始的索引。
在训练过程中,只有一个可能的答案。我们也可以使用 Dataset.filter() 方法来进行检查:
raw_datasets["train"].filter(lambda x: len(x["answers"]["text"]) != 1)
Dataset({
    features: ['id', 'title', 'context', 'question', 'answers'],
    num_rows: 0
})
然而,在评估过程中,每个样本可能有多个答案,这些答案可能相同或不同:
print(raw_datasets["validation"][0]["answers"])
print(raw_datasets["validation"][2]["answers"])
{'text': ['Denver Broncos', 'Denver Broncos', 'Denver Broncos'], 'answer_start': [177, 177, 177]}
{'text': ['Santa Clara, California', "Levi's Stadium", "Levi's Stadium in the San Francisco Bay Area at Santa Clara, California."], 'answer_start': [403, 355, 355]}
我们不会深入探究评估的代码,因为所有的东西都将由🤗 Datasets metric 帮我们完成,但简单来说,一些问题可能有多个可能的答案,而该评估代码将把预测的答案与所有可接受的答案进行比较,并选择最佳分数。例如,让我们看一下索引为 2 的样本:
print(raw_datasets["validation"][2]["context"])
print(raw_datasets["validation"][2]["question"])
'Super Bowl 50 was an American football game to determine the champion of the National Football League (NFL) for the 2015 season. The American Football Conference (AFC) champion Denver Broncos defeated the National Football Conference (NFC) champion Carolina Panthers 24–10 to earn their third Super Bowl title. The game was played on February 7, 2016, at Levi\'s Stadium in the San Francisco Bay Area at Santa Clara, California. As this was the 50th Super Bowl, the league emphasized the "golden anniversary" with various gold-themed initiatives, as well as temporarily suspending the tradition of naming each Super Bowl game with Roman numerals (under which the game would have been known as "Super Bowl L"), so that the logo could prominently feature the Arabic numerals 50.'
'Where did Super Bowl 50 take place?'
我们可以看到,答案的确可能是我们之前看到的三个可能选择 ['Denver Broncos', 'Denver Broncos', 'Denver Broncos'] 的之一。
处理训练数据
我们从预处理训练数据开始。最困难的部分将是生成问题答案的位置,即找到 Context 中对应答案 token 的起始和结束位置。
但我们不要急于求成。首先,我们需要使用 tokenizer 将输入中的文本转换为模型可以理解的 ID:
from transformers import AutoTokenizer

model_checkpoint = "bert-base-cased"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
如前所述,我们将对 BERT 模型进行微调,但你可以使用任何其他模型类型,只要它实现了快速 tokenizer 即可。你可以在 支持快速 tokenizer 的框架 表中看到所有带有快速版本的架构,要检查你正在使用的 tokenizer 对象是否真的是由🤗 Tokenizers 支持的,你可以查看它的 is_fast 属性:
tokenizer.is_fast
True
我们可以将 question 和 context 一起传递给我们的 tokenizer 它会正确插入特殊 tokens 形成如下句子:
[CLS] question [SEP] context [SEP]
让我们检查一下处理后的样本:
context = raw_datasets["train"][0]["context"]
question = raw_datasets["train"][0]["question"]

inputs = tokenizer(question, context)
tokenizer.decode(inputs["input_ids"])
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] Architecturally, '
'the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin '
'Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms '
'upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred '
'Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a '
'replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette '
'Soubirous in 1858. At the end of the main drive ( and in a direct line that connects through 3 statues '
'and the Gold Dome ), is a simple, modern stone statue of Mary. [SEP]'
需要预测的是答案起始和结束 token 的索引,模型的任务是为输入中的每个标记预测一个起始和结束的 logit 值,理论上的预测的结果如下所示:

在做个例子中,Context 没有很长,但是数据集中的一些示例的 Context 会很长,会超过我们设置的最大长度(本例中为 384)。正如我们在 第六章 中所看到的,当我们探索 question-answering 管道的内部结构时,我们会通过将一个样本的较长的 Context 划分成多个片段,并在这些片段之间使用滑动窗口,来处理较长的 Context。
要了解在这个过程中对当前的训练样本进行了哪些处理,我们可以将长度限制为 100,并使用长度为 50 的 token 窗口。我们将设置以下的参数:
max_length来设置最大长度 (这里为 100)truncation="only_second"在问题和 Context 过长时截断 Context(Context 位于第二个位置,第一个是 Question)stride设置两个连续块之间的重叠 tokens 数 (这里为 50)return_overflowing_tokens=True告诉 tokenizer 我们想要保留超过长度的 tokens
inputs = tokenizer(
    question,
    context,
    max_length=100,
    truncation="only_second",
    stride=50,
    return_overflowing_tokens=True,
)

for ids in inputs["input_ids"]:
    print(tokenizer.decode(ids))
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] Architecturally, the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basi [SEP]'
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a replica of the grotto at Lourdes, France where the Virgin [SEP]'
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette Soubirous in 1858. At the end of the main drive ( and in a direct line that connects through 3 [SEP]'
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP]. It is a replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette Soubirous in 1858. At the end of the main drive ( and in a direct line that connects through 3 statues and the Gold Dome ), is a simple, modern stone statue of Mary. [SEP]'
如我们所见,示例文本被拆分成四个输入,每个输入都包含问题和 Context 的一部分。请注意,问题的答案 (“Bernadette Soubirous”) 仅出现在第三个和最后一个片段中,因此通过以这种方式处理较长的 Context 时,我们可能创建一些 Context 中不包含答案的训练样本。我们把这些样本的标签设置为 start_position = end_position = 0 (这样的话,实际上我们的答案指向了 [CLS] tokens)。如果答案被截断,那么只在这一部分预测答案的起始(或结束)的token 的索引。对于答案完全在 Context 中的示例,标签将是答案起始的 token 的索引和答案结束的 token 的索引。
数据集为我们提供了 Context 中答案的起始的位置索引,加上答案的长度,我们可以找到 Context 中的结束索引。要将它们映射到 tokens 索引,我们将需要使用我们在 第六章 中学到的偏移映射。我们可以通过使用 return_offsets_mapping=True,让我们的 tokenizer 返回偏移后的映射:
inputs = tokenizer(
    question,
    context,
    max_length=100,
    truncation="only_second",
    stride=50,
    return_overflowing_tokens=True,
    return_offsets_mapping=True,
)
inputs.keys()
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'offset_mapping', 'overflow_to_sample_mapping'])
如我们所见,我们得到了 inputs ID、tokens 类型 ID 和注意力掩码,以及我们所需的偏移映射和一个额外的 overflow_to_sample_mapping 。当我们同时对多个文本并行 tokenize 时,为了从支持 Rust 中受益,这个键的值对我们很有用。由于一个长的样本可以切分为多个短的样本,它保存了这些短的样本是来自于哪个长的样本。因为这里我们只对一个样本进行了 tokenize,所以我们得到一个由 0 组成的列表:
inputs["overflow_to_sample_mapping"]
[0, 0, 0, 0]
但是,如果我们对更多的示例进行 tokenize ,它会变得更加有用:
inputs = tokenizer(
    raw_datasets["train"][2:6]["question"],
    raw_datasets["train"][2:6]["context"],
    max_length=100,
    truncation="only_second",
    stride=50,
    return_overflowing_tokens=True,
    return_offsets_mapping=True,
)

print(f"The 4 examples gave {len(inputs['input_ids'])} features.")
print(f"Here is where each comes from: {inputs['overflow_to_sample_mapping']}.")
'The 4 examples gave 19 features.'
'Here is where each comes from: [0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 3, 3, 3].'
在我们的这个例子中,前三条数据 (在训练集中的索引 2、3 和 4 处) 每条数据被拆分为4个样本,最后一条数据(在训练集中的索引 5 处) 拆分为了5个样本。
这些信息将有助于将我们拆分后的文本块映射到其相应的标签。如前所述,这些标签的规则是:
- 如果答案不在相应上下文的范围内,则为
(0, 0) - 如果答案在相应上下文的范围内,则为
(start_position, end_position),其中start_position是答案起始处的 token 索引(在 inputs ID 中),end_position是答案结束处的 token 索引(在 inputs ID 中)
为了确定这两种情况中的哪一种,并且如果是第二种,则需要确定 token 的位置,我们首先找到在输入 ID 中起始和结束上下文的索引。我们首先找到拆分后的每一个部分在 Context 起始和结束的索引,可以使用 token 类型 ID 来完成此操作,但由于并非所有模型都支持这样的操作(如DistilBERT),因此可以使用 tokenizer 的 sequence_ids() 函数返回的 BatchEncoding 对象。
有了这些 tokens 的索引之后,我们就可以计算相应的偏移量了,它们是两个整数的元组,表示原始 Context 中的字符范围。因此,我们可以检测每个分块中的 Context 块是在答案之后起始还是在答案起始之前结束(在这种情况下,标签是 (0, 0) )。如果答案就在 Context 里,我们就循环查找答案的第一个和最后一个 token:
answers = raw_datasets["train"][2:6]["answers"]
start_positions = []
end_positions = []

for i, offset in enumerate(inputs["offset_mapping"]):
    sample_idx = inputs["overflow_to_sample_mapping"][i]
    answer = answers[sample_idx]
    start_char = answer["answer_start"][0]
    end_char = answer["answer_start"][0] + len(answer["text"][0])
    sequence_ids = inputs.sequence_ids(i)

    # 找到上下文的起始和结束
    idx = 0
    while sequence_ids[idx] != 1:
        idx += 1
    context_start = idx
    while sequence_ids[idx] == 1:
        idx += 1
    context_end = idx - 1

    # 如果答案不完全在上下文内,标签为(0, 0)
    if offset[context_start][0] > start_char or offset[context_end][1] < end_char:
        start_positions.append(0)
        end_positions.append(0)
    else:
        # 否则,它就是起始和结束 token 的位置
        idx = context_start
        while idx <= context_end and offset[idx][0] <= start_char:
            idx += 1
        start_positions.append(idx - 1)

        idx = context_end
        while idx >= context_start and offset[idx][1] >= end_char:
            idx -= 1
        end_positions.append(idx + 1)

start_positions, end_positions
([83, 51, 19, 0, 0, 64, 27, 0, 34, 0, 0, 0, 67, 34, 0, 0, 0, 0, 0],
 [85, 53, 21, 0, 0, 70, 33, 0, 40, 0, 0, 0, 68, 35, 0, 0, 0, 0, 0])
让我们查看一些结果来验证一下我们的方法是否正确。在拆分后的第一个部分的文本中,我们看到了 (83, 85) 是待预测的标签值,因此让我们将理论答案与从 83 到 85(包括 85)的 tokens 解码的结果进行比较:
idx = 0
sample_idx = inputs["overflow_to_sample_mapping"][idx]
answer = answers[sample_idx]["text"][0]

start = start_positions[idx]
end = end_positions[idx]
labeled_answer = tokenizer.decode(inputs["input_ids"][idx][start : end + 1])

print(f"Theoretical answer: {answer}, labels give: {labeled_answer}")
'Theoretical answer: the Main Building, labels give: the Main Building'
很好!寻找的答案是正确的!现在让我们来看一下拆分后的第4个文本块,我们我们得到的标签是 (0, 0) ,这意味着答案不在这个文本块中:
idx = 4
sample_idx = inputs["overflow_to_sample_mapping"][idx]
answer = answers[sample_idx]["text"][0]
decoded_example = tokenizer.decode(inputs["input_ids"][idx])
print(f"Theoretical answer: {answer}, decoded example: {decoded_example}")
'Theoretical answer: a Marian place of prayer and reflection, decoded example: [CLS] What is the Grotto at Notre Dame? [SEP] Architecturally, the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grot [SEP]'
确实,我们在 Context 中没有看到答案。
✏️ 轮你来了! 在使用 XLNet 架构时,如果截取后的文本长度没有达到设定的最大长度,需要在左侧进行填充,并且需要交互问题和 Context 的顺序。尝试将我们刚刚看到的所有代码调整为 XLNet 架构(并添加
padding=True)。请注意,因为是在左侧填充的,所以填充后的[CLS]tokens 可能不在索引为 0 的位置。
现在,我们已经逐步了解了如何预处理我们的训练数据,接下来可以将其组合到一个函数中,并使用该函数处理整个训练数据集。我们将每个拆分后的样本都填充到我们设置的最大长度,因为大多数上下文都很长(相应的样本会被分割成几小块),所以在这里进行动态填充的所带来的增益不是很大。
max_length = 384
stride = 128
def preprocess_training_examples(examples):
questions = [q.strip() for q in examples["question"]]
inputs = tokenizer(
questions,
examples["context"],
max_length=max_length,
truncation="only_second",
stride=stride,
return_overflowing_tokens=True,
return_offsets_mapping=True,
padding="max_length",
)
offset_mapping = inputs.pop("offset_mapping")
sample_map = inputs.pop("overflow_to_sample_mapping")
answers = examples["answers"]
start_positions = []
end_positions = []
for i, offset in enumerate(offset_mapping):
sample_idx = sample_map[i]
answer = answers[sample_idx]
start_char = answer["answer_start"][0]
end_char = answer["answer_start"][0] + len(answer["text"][0])
sequence_ids = inputs.sequence_ids(i)
# 找到上下文的起始和结束
idx = 0
while sequence_ids[idx] != 1:
idx += 1
context_start = idx
while sequence_ids[idx] == 1:
idx += 1
context_end = idx - 1
# 如果答案不完全在上下文内,标签为(0, 0)
if offset[context_start][0] > start_char or offset[context_end][1] < end_char:
start_positions.append(0)
end_positions.append(0)
else:
# 否则,它就是起始和结束 tokens 的位置
idx = context_start
while idx <= context_end and offset[idx][0] <= start_char:
idx += 1
start_positions.append(idx - 1)
idx = context_end
while idx >= context_start and offset[idx][1] >= end_char:
idx -= 1
end_positions.append(idx + 1)
inputs["start_positions"] = start_positions
inputs["end_positions"] = end_positions
return inputs
请注意,我们定义了两个常量来确定所使用的最大长度以及滑动窗口的长度,并且在之前 tokenize 之前对数据进行了一些清洗:SQuAD 数据集中的一些问题在开头和结尾有额外的空格,这些空格没有任何意义(如果你使用像 RoBERTa 这样的模型,它们会占用 tokenize 的长度),因此我们去掉了这些额外的空格。
要使用该函数处理整个训练集,我们可以使用 Dataset.map() 方法并设置 batched=True 参数。这是必要的,因为我们正在更改数据集的长度(因为一个样本可能会产生多个子样本):
train_dataset = raw_datasets["train"].map(
preprocess_training_examples,
batched=True,
remove_columns=raw_datasets["train"].column_names,
)
len(raw_datasets["train"]), len(train_dataset)
(87599, 88729)
如我们所见,预处理增加了大约 1000 个样本。我们的训练集现在已经准备好使用了——让我们深入研究一下验证集的预处理!
处理验证数据
验证集的预处理会更加容易,因为我们不需要生成标签(除非我们想计算验证损失,但那个数字并不能真正帮助我们了解模型的好坏,如果要评估模型更好的方式使用我们之前提到的squad 指标)。真正的挑战在于将模型的预测转化为为原始 Context 的片段。为此,我们只需要存储偏移映射并且找到一种方法来将每个分割后的样本与分割前的原始片段匹配起来。由于原始数据集中有一个 ID 列,我们可以使用ID来代表原始的片段。
我们唯一需要做的是对偏移映射进行一些微小修改。偏移映射包含问题和 Context 的偏移量(问题的偏移量是0,Context 是1),但当我们进入后处理阶段,我们将无法知道 inputs ID 的哪个部分对应于 Context,哪个部分是问题(我们使用的 sequence_ids() 方法仅可用于 tokenizer 的输出)。因此,我们将将与问题对应的偏移设置为 None Context 对应的偏移量保持不变:
def preprocess_validation_examples(examples):
questions = [q.strip() for q in examples["question"]]
inputs = tokenizer(
questions,
examples["context"],
max_length=max_length,
truncation="only_second",
stride=stride,
return_overflowing_tokens=True,
return_offsets_mapping=True,
padding="max_length",
)
sample_map = inputs.pop("overflow_to_sample_mapping")
example_ids = []
for i in range(len(inputs["input_ids"])):
sample_idx = sample_map[i]
example_ids.append(examples["id"][sample_idx])
sequence_ids = inputs.sequence_ids(i)
offset = inputs["offset_mapping"][i]
inputs["offset_mapping"][i] = [
o if sequence_ids[k] == 1 else None for k, o in enumerate(offset)
]
inputs["example_id"] = example_ids
return inputs
我们可以像处理训练集一样使用此函数处理整个验证数据集:
validation_dataset = raw_datasets["validation"].map(
preprocess_validation_examples,
batched=True,
remove_columns=raw_datasets["validation"].column_names,
)
len(raw_datasets["validation"]), len(validation_dataset)
(10570, 10822)
从最终的结果来看,我们只添加了几百个样本,因此验证数据集中的 Context 似乎要短一些。
现在我们已经对所有数据进行了预处理,我们可以开始训练了。
使用 Trainer API 微调模型
这个例子的训练代码与前面的部分非常相似,最困难的部分是编写 compute_metrics() 评估指标函数。由于我们将所有样本填充到了我们设置的最大长度,所以没有需要定义的数据整理器,因此我们唯一需要担心的事情是如何计算评估指标。比较困难的部分将是将模型预测的结果还原到原始示例中的文本片段;一旦我们完成了这一步骤,🤗 Datasets 库中的 metric 就可以帮助我们做大部分工作。
后处理
模型将输出答案在 inputs ID 中起始和结束位置的 logit,正如我们在探索 question-answering pipeline 时看到的那样。后处理步骤与我们在那里所做的很相似,所以这里简单回顾一下我们所采取的操作:
- 我们屏蔽了除了 Context 之外的 tokens 对应的起始和结束 logit。
- 然后,我们使用 softmax 将起始和结束 logits 转换为概率。
- 我们通过将两个概率对应的乘积来为每个
(start_token, end_token)对计算一个分数。 - 我们寻找具有最大分数且产生有效答案(例如,
start_token小于end_token)的对。
这次我们将稍微改变这个流程,因为我们不需要计算实际分数(只需要预测的答案的文本)。这意味着我们可以跳过 softmax 步骤(因为 softmax 并不会改变分数大小的排序)。为了加快计算速度,我们也不会为所有可能的 (start_token, end_token) 对计算分数,而只会计算与最高的 n_best 对应的 logit 分数(其中 n_best=20 )。由于我们将跳过 softmax,这些分数将是 logit 分数,而且是起始和结束对数概率的和(而不是乘积,因为对数运算规则: ($\log(ab) = \log(a) + \log(b))$。
为了验证猜想,我们需要一些预测。由于我们还没有训练我们的模型,我们将使用 QA 管道的默认模型对一小部分验证集生成一些预测。我们可以使用和之前一样的处理函数;因为它依赖于全局常量 tokenizer ,我们只需将该对象更改为我们要临时使用的模型的 tokenizer
为了测试这些代码,我们需要一些预测结果。由于我们还没有训练模型,我们将使用 QA pipeline 的默认模型在验证集的一小部分上生成一些预测结果。我们可以使用与之前相同的处理函数;因为它依赖于全局常量 tokenizer ,所以只需将其更改为这次临时使用的模型对应的 tokenizer 即可。
small_eval_set = raw_datasets["validation"].select(range(100))
trained_checkpoint = "distilbert-base-cased-distilled-squad"
tokenizer = AutoTokenizer.from_pretrained(trained_checkpoint)
eval_set = small_eval_set.map(
preprocess_validation_examples,
batched=True,
remove_columns=raw_datasets["validation"].column_names,
)
现在预处理已经完成,我们将 tokenizer 改回我们最初选择的 tokenizer :
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
然后我们移除 eval_set 中模型不需要的列,构建一个包含所有小型验证集数据的 batch,并将其传递给模型。如果有可用的 GPU,我们将使用 GPU 以加快计算:
import torch
from transformers import AutoModelForQuestionAnswering
eval_set_for_model = eval_set.remove_columns(["example_id", "offset_mapping"])
eval_set_for_model.set_format("torch")
device = torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
batch = {k: eval_set_for_model[k].to(device) for k in eval_set_for_model.column_names}
trained_model = AutoModelForQuestionAnswering.from_pretrained(trained_checkpoint).to(
device
)
with torch.no_grad():
outputs = trained_model(**batch)
为了便于实验,让我们将这些输出转换为 NumPy 数组:
start_logits = outputs.start_logits.cpu().numpy()
end_logits = outputs.end_logits.cpu().numpy()
现在,我们需要找到 small_eval_set 中每个样本的预测答案。一个样本可能会被拆分成 eval_set 中的多个子样本,所以第一步是将 small_eval_set 中的每个样本映射到 eval_set 中对应的子样本:
import collections
example_to_features = collections.defaultdict(list)
for idx, feature in enumerate(eval_set):
example_to_features[feature["example_id"]].append(idx)
有了这个映射,我们可以通过循环遍历所有样本,并遍历每个样本的所有子样本。正如之前所说,我们将查看 n_best 个起始 logit 和结束 logit 的得分,排除以下情况:
- 答案不在上下文中
- 答案长度为负数
- 答案过长(我们将长度限制为
max_answer_length=30)
当我们得到一个样本的所有得分可能答案,我们只需选择具有最佳 logit 得分的答案:
import numpy as np
n_best = 20
max_answer_length = 30
predicted_answers = []
for example in small_eval_set:
example_id = example["id"]
context = example["context"]
answers = []
for feature_index in example_to_features[example_id]:
start_logit = start_logits[feature_index]
end_logit = end_logits[feature_index]
offsets = eval_set["offset_mapping"][feature_index]
start_indexes = np.argsort(start_logit)[-1 : -n_best - 1 : -1].tolist()
end_indexes = np.argsort(end_logit)[-1 : -n_best - 1 : -1].tolist()
for start_index in start_indexes:
for end_index in end_indexes:
# 跳过不完全在上下文中的答案
if offsets[start_index] is None or offsets[end_index] is None:
continue
# 跳过长度为负数或大于 max_answer_length 的答案。
if (
end_index < start_index
or end_index - start_index + 1 > max_answer_length
):
continue
answers.append(
{
"text": context[offsets[start_index][0] : offsets[end_index][1]],
"logit_score": start_logit[start_index] + end_logit[end_index],
}
)
best_answer = max(answers, key=lambda x: x["logit_score"])
predicted_answers.append({"id": example_id, "prediction_text": best_answer["text"]})
完成上述处理后,预测答案就变成了我们将使用的评估指标所要求的输入的格式,在这种情况下可以借助🤗 Evaluate 库来加载它。
import evaluate
metric = evaluate.load("squad")
这个评估指标一个如上所示格式(一个包含示例 ID 和预测文本的字典列表)的预测答案,同时也需要一个如下格式(一个包含示例 ID 和可能答案的字典列表)的参考答案:
该评估指标需要一个由样本 ID 和预测文本字典的列表组成预测答案,同时也需要一个由参考ID 和可能答案字典的列表组成参考答案。
theoretical_answers = [
{"id": ex["id"], "answers": ex["answers"]} for ex in small_eval_set
]
现在,我们可以通过查看两个列表中的第一个元素来检查是否符合评估指标的要求:
print(predicted_answers[0])
print(theoretical_answers[0])
{'id': '56be4db0acb8001400a502ec', 'prediction_text': 'Denver Broncos'}
{'id': '56be4db0acb8001400a502ec', 'answers': {'text': ['Denver Broncos', 'Denver Broncos', 'Denver Broncos'], 'answer_start': [177, 177, 177]}}
还不错!现在让我们看一下评估指标给出的分数:
metric.compute(predictions=predicted_answers, references=theoretical_answers)
{'exact_match': 83.0, 'f1': 88.25}
根据 DistilBERT 的论文 所述,DistilBERT 在 SQuAD 上微调后整体数据集的得分为 79.1 和 86.9,相比之下我们取得的结果相当不错。
现在,让我们将刚才所做的放入 compute_metrics() 函数中,就可以在 Trainer 中使用它了。通常, compute_metrics() 函数只接收一个包含 logits 和带预测标签组成的 eval_preds 元组。但是在这里,我们需要更多的信息才能评估结果,因为我们需要在分割后的数据集中查找偏移量,并在原始数据集中查找原始 Context,因此我们无法在训练过程中使用此函数来获取常规的评估结果。我们只会在训练结束时使用它来检查训练的结果。 compute_metrics() 函数与之前的步骤相同;我们只是添加了一个小的检查,以防我们找不到任何有效的答案(在这种情况下,我们的预测会输出一个空字符串)。
from tqdm.auto import tqdm
def compute_metrics(start_logits, end_logits, features, examples):
example_to_features = collections.defaultdict(list)
for idx, feature in enumerate(features):
example_to_features[feature["example_id"]].append(idx)
predicted_answers = []
for example in tqdm(examples):
example_id = example["id"]
context = example["context"]
answers = []
# 循环遍历与该示例相关联的所有特征
for feature_index in example_to_features[example_id]:
start_logit = start_logits[feature_index]
end_logit = end_logits[feature_index]
offsets = features[feature_index]["offset_mapping"]
start_indexes = np.argsort(start_logit)[-1 : -n_best - 1 : -1].tolist()
end_indexes = np.argsort(end_logit)[-1 : -n_best - 1 : -1].tolist()
for start_index in start_indexes:
for end_index in end_indexes:
# 跳过不完全位于上下文中的答案
if offsets[start_index] is None or offsets[end_index] is None:
continue
# 跳过长度小于 0 或大于 max_answer_length 的答案
if (
end_index < start_index
or end_index - start_index + 1 > max_answer_length
):
continue
answer = {
"text": context[offsets[start_index][0] : offsets[end_index][1]],
"logit_score": start_logit[start_index] + end_logit[end_index],
}
answers.append(answer)
# 选择得分最高的答案
if len(answers) > 0:
best_answer = max(answers, key=lambda x: x["logit_score"])
predicted_answers.append(
{"id": example_id, "prediction_text": best_answer["text"]}
)
else:
predicted_answers.append({"id": example_id, "prediction_text": ""})
theoretical_answers = [{"id": ex["id"], "answers": ex["answers"]} for ex in examples]
return metric.compute(predictions=predicted_answers, references=theoretical_answers)
我们可以评估我们模型在评估数据集输出的结果:
compute_metrics(start_logits, end_logits, eval_set, small_eval_set)
{'exact_match': 83.0, 'f1': 88.25}
看起来不错!现在让我们使用它来微调我们的模型。
微调模型
现在我们已经准备好训练我们的模型了。首先,让我们像之前一样使用 AutoModelForQuestionAnswering 类创建模型:
model = AutoModelForQuestionAnswering.from_pretrained(model_checkpoint)
和之前一样,我们会收到一个警告,提示有些权重没有被使用(来自预训练头部的权重),而其他一些权重是随机初始化的(用于问答头部的权重)。你现在应该已经习惯了这种情况,但这意味着这个模型还没有准备好使用,需要进行微调——好在这正是我们接下来要做的事情!
为了能够将我们的模型推送到 Hub,我们需要登录 Hugging Face。如果你在 Notebook 中运行此代码,则可以使用以下的函数执行此操作,该函数会显示一个小部件,你可以在其中输入登录凭据进行登陆:
from huggingface_hub import notebook_login
notebook_login()
如果你不在 Notebook 中工作,只需在终端中输入以下行:
huggingface-cli login
完成后,我们就可以定义我们的 TrainingArguments 。正如我们在定义计算评估函数时所说的,由于 compute_metrics() 函数的输入参数限制,我们无法使用常规的方法来编写评估循环。不过,我们可以编写自己的 Trainer 子类来实现这一点(你可以在 问答示例代码 中找到该方法),但放在本节中会有些冗长。因此,我们在这里将仅在训练结束时评估模型,并在下面的“自定义训练循环”中向你展示如何使用常规的方法进行评估。
这确实是 Trainer API 局限性的地方,而🤗 Accelerate 库则非常适合处理这种情况:定制化特定用例的类可能会很繁琐,但定制化调整训练循环却很简单。
让我们来看看我们的 TrainingArguments :
from transformers import TrainingArguments
args = TrainingArguments(
"bert-finetuned-squad",
evaluation_strategy="no",
save_strategy="epoch",
learning_rate=2e-5,
num_train_epochs=3,
weight_decay=0.01,
fp16=True,
push_to_hub=True,
)
我们之前已经见过其中大部分内容:我们设置了一些超参数(如学习率、训练的周期数和一些权重衰减),并设定我们想在每个周期结束时保存模型、跳过评估,并将结果上传到模型中心。我们还启用了 fp16=True 的混合精度训练,因为它可以在最新的 GPU 上加快训练速度。
默认情况下,使用的仓库将保存在你的账户中,并以你设置的输出目录命名,所以在我们的例子中它将位于 "sgugger/bert-finetuned-squad" 中。我们可以通过传递一个 hub_model_id 参数来覆盖这个设置;例如,要将模型推送到我们使用的 huggingface_course 组织中,我们使用了 hub_model_id="huggingface_course/bert-finetuned-squad" (这是我们在本节开始时演示的模型)。
💡 如果你正在使用的输出目录已经存在一个同名的文件,则它需要是你要推送到的存储库克隆在本地的版本(因此,如果在定义你的
Trainer时出现错误,请设置一个新的名称)。
最后,我们只需将所有内容传递给 Trainer 类并启动训练:
from transformers import Trainer
trainer = Trainer(
model=model,
args=args,
train_dataset=train_dataset,
eval_dataset=validation_dataset,
tokenizer=tokenizer,
)
trainer.train()
请注意,在训练过程中,每次模型保存(例如,每个 epoch 结束时),模型都会在后台上传到 Hub。这样,如果需要的话,你就可以在另一台机器上恢复训练。整个训练过程需要一些时间(在 Titan RTX 上略超过一个小时),所以你可以喝杯咖啡或者重新阅读一些你觉得更具挑战性的课程部分来消磨时间。还要注意,在第一个 epoch 完成后,你可以看到一些权重上传到 Hub,并且你可以在其页面上开始使用你的模型进行测试。
训练完成后,我们就可以评估我们最终的模型了(并祈祷我们可以一次成功)。 Trainer 的 predict() 方法将返回一个元组,其中第一个元素将是模型的预测结果(在这里是一个包含起始和结束 logits 的数值对)。我们将这个结果传递给我们的 compute_metrics() 函数:
predictions, _, _ = trainer.predict(validation_dataset)
start_logits, end_logits = predictions
compute_metrics(start_logits, end_logits, validation_dataset, raw_datasets["validation"])
{'exact_match': 81.18259224219489, 'f1': 88.67381321905516}
很棒!作为对比,BERT 文章中报告的该模型的基准分数分别为 80.8 和 88.5,所以我们的结果正好达到了预期分数。
最后,我们使用 push_to_hub() 方法确保上传模型的最新版本:
trainer.push_to_hub(commit_message="Training complete")
如果你想检查它,上面的代码返回它刚刚执行的提交的 URL:
'https://huggingface.co/sgugger/bert-finetuned-squad/commit/9dcee1fbc25946a6ed4bb32efb1bd71d5fa90b68'
Trainer 还会创建一个包含所有评估结果的模型卡片,并将其上传。
在这个阶段,你可以使用模型库中的推理小部件来测试模型,并与你的朋友、家人和同伴分享。恭喜你成功地在问答任务上对模型进行了微调!
✏️ 轮到你了! 尝试使用另一个模型架构,看看它在这个任务上表现得是否更好!
如果你想更深入地了解训练循环,我们现在将向你展示如何使用 🤗 Accelerate 来做同样的事情。
自定义训练循环
现在,让我们来看一下完整的训练循环,这样你就可以轻松地自定义所需的部分。它看起来很像 第三章 中的训练循环,只是评估的过程有所不同。由于我们不再受 Trainer 类的限制,因此我们可以在模型训练的过程中定期评估模型。
为训练做准备
首先,我们需要使用数据集构建 DataLoader 。我们将这些数据集的格式设置为 "torch" ,并删除模型不使用的验证集的列。然后,我们可以使用 Transformers 提供的 default_data_collator 作为 collate_fn ,并打乱训练集,但不打乱验证集:
from torch.utils.data import DataLoader
from transformers import default_data_collator
train_dataset.set_format("torch")
validation_set = validation_dataset.remove_columns(["example_id", "offset_mapping"])
validation_set.set_format("torch")
train_dataloader = DataLoader(
train_dataset,
shuffle=True,
collate_fn=default_data_collator,
batch_size=8,
)
eval_dataloader = DataLoader(
validation_set, collate_fn=default_data_collator, batch_size=8
)
接下来,我们重新实例化我们的模型,以确保我们不是从上面的微调继续训练,而是从原始的 BERT 预训练模型重新开始训练:
model = AutoModelForQuestionAnswering.from_pretrained(model_checkpoint)
然后,我们需要一个优化器。通常我们使用经典的 AdamW 优化器,它与 Adam 类似,不过在权重衰减的方式上有些不同:
from torch.optim import AdamW
optimizer = AdamW(model.parameters(), lr=2e-5)
当我们拥有了所有这些对象,我们可以将它们发送到 accelerator.prepare() 方法。请记住,如果你想在 Colab Notebook 上使用 TPU 进行训练,你需要将所有这些代码移到一个训练函数中,不要在 Colab Notebook 的单元格中直接实例化 Accelerator 对象。这是因为在 TPU 环境下,直接在单元格中实例化可能会导致资源分配和初始化的问题。此外我们还可以通过向 Accelerator 传递 fp16=True 来强制使用混合精度训练(或者,如果你想要将代码作为脚本执行,只需确保填写正确的🤗 Accelerate config )。
from accelerate import Accelerator
accelerator = Accelerator(fp16=True)
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
model, optimizer, train_dataloader, eval_dataloader
)
从前面几节中你应该知道,我们只有在 train_dataloader 通过 accelerator.prepare() 方法后才能使用其长度来计算训练步骤的数量。我们使用与之前章节相同的线性学习率调度:
from transformers import get_scheduler
num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch
lr_scheduler = get_scheduler(
"linear",
optimizer=optimizer,
num_warmup_steps=0,
num_training_steps=num_training_steps,
)
要将模型推送到 Hub,我们需要在工作文件夹中创建一个 Repository 对象。如果你尚未登录 Hugging Face Hub,请先登录。我们将根据我们给模型指定的模型 ID 确定仓库名称(可以根据自己的选择替换 repo_name ;只需要包含你的用户名即可,用户名可以使用 get_full_repo_name() 函数可以获取):
from huggingface_hub import Repository, get_full_repo_name
model_name = "bert-finetuned-squad-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/bert-finetuned-squad-accelerate'
然后,我们可以将该存储库克隆到本地文件夹中。如果在设定的目录中已经存在一个同名的文件夹,那么这个本地文件夹应该是我们正在使用的仓库克隆在本地的版本,否则它会报错:
output_dir = "bert-finetuned-squad-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
现在,我们可以通过调用 repo.push_to_hub() 方法上传保存在 output_dir 中的所有内容。这将帮助我们在每个时期结束时上传中间模型。
训练循环
现在,我们准备编写完整的训练循环。在定义一个进度条以跟踪训练进度之后,循环分为三个部分:
- 训练本身,即对
train_dataloader进行迭代,模型前向传播、反向传播和优化器更新。 - 评估,我们将遍历整个评估数据集,同时收集
start_logits和end_logits中的所有值。完成评估循环后,我们会将所有结果汇总到一起。需要注意的是,由于Accelerator可能会在最后添加一些额外的样本,以确保每个进程中的样本数量相同,因此我们需要对这些数据进行截断,以防止多余样本影响最终结果。 - 保存和上传,首先保存模型和 Tokenizer,然后调用
repo.push_to_hub()。与之前一样,我们使用blocking=False参数告诉🤗 Hub 库在异步进程中推送。这样,训练将继续进行,而这个(需要很长时间的)上传指令将在后台异步执行。
以下训练循环的完整代码:
from tqdm.auto import tqdm
import torch
progress_bar = tqdm(range(num_training_steps))
for epoch in range(num_train_epochs):
# 训练
model.train()
for step, batch in enumerate(train_dataloader):
outputs = model(**batch)
loss = outputs.loss
accelerator.backward(loss)
optimizer.step()
lr_scheduler.step()
optimizer.zero_grad()
progress_bar.update(1)
# 评估
model.eval()
start_logits = []
end_logits = []
accelerator.print("Evaluation!")
for batch in tqdm(eval_dataloader):
with torch.no_grad():
outputs = model(**batch)
start_logits.append(accelerator.gather(outputs.start_logits).cpu().numpy())
end_logits.append(accelerator.gather(outputs.end_logits).cpu().numpy())
start_logits = np.concatenate(start_logits)
end_logits = np.concatenate(end_logits)
start_logits = start_logits[: len(validation_dataset)]
end_logits = end_logits[: len(validation_dataset)]
metrics = compute_metrics(
start_logits, end_logits, validation_dataset, raw_datasets["validation"]
)
print(f"epoch {epoch}:", metrics)
# 保存和上传
accelerator.wait_for_everyone()
unwrapped_model = accelerator.unwrap_model(model)
unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
if accelerator.is_main_process:
tokenizer.save_pretrained(output_dir)
repo.push_to_hub(
commit_message=f"Training in progress epoch {epoch}", blocking=False
)
如果这是你第一次看到使用🤗 Accelerate 保存的模型,请花点时间了解一下与之相关的三行代码
accelerator.wait_for_everyone()
unwrapped_model = accelerator.unwrap_model(model)
unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
第一行很好理解:它告诉所有进程在继续之前等待所有进程都到达该阶段。这是为了确保我们在保存之前,在每个进程中都有相同的模型。然后,我们获取 unwrapped_model ,它是我们定义的基本模型。 accelerator.prepare() 方法会更改模型来适应分布式训练,因此它不再具有 save_pretrained() 方法;使用 accelerator.unwrap_model() 方法可以撤消这个更改。最后,我们调用 save_pretrained() ,告诉该方法应该使用 accelerator.save() 保存模型 而不是 torch.save() 。
完成后,你应该拥有一个产生与使用 Trainer 训练的模型非常相似的结果的模型。你可以在 huggingface-course/bert-finetuned-squad-accelerate 查看我们使用此代码训练的模型。如果你想测试对训练循环进行的任何调整,可以直接通过编辑上面显示的代码来实现!
使用微调模型
我们已经向你展示了如何使用在模型中心上进行微调的模型,并使用推理小部件进行测试。要在本地使用 pipeline 来使用微调的模型,你只需指定模型标识符:
from transformers import pipeline
# 将其替换为你自己的 checkpoint
model_checkpoint = "huggingface-course/bert-finetuned-squad"
question_answerer = pipeline("question-answering", model=model_checkpoint)
context = """
🤗 Transformers is backed by the three most popular deep learning libraries — Jax, PyTorch and TensorFlow — with a seamless integration
between them. It's straightforward to train your models with one before loading them for inference with the other.
"""
question = "Which deep learning libraries back 🤗 Transformers?"
question_answerer(question=question, context=context)
{'score': 0.9979003071784973,
'start': 78,
'end': 105,
'answer': 'Jax, PyTorch and TensorFlow'}
很棒!我们的模型与 pipeline 的默认模型一样有效!